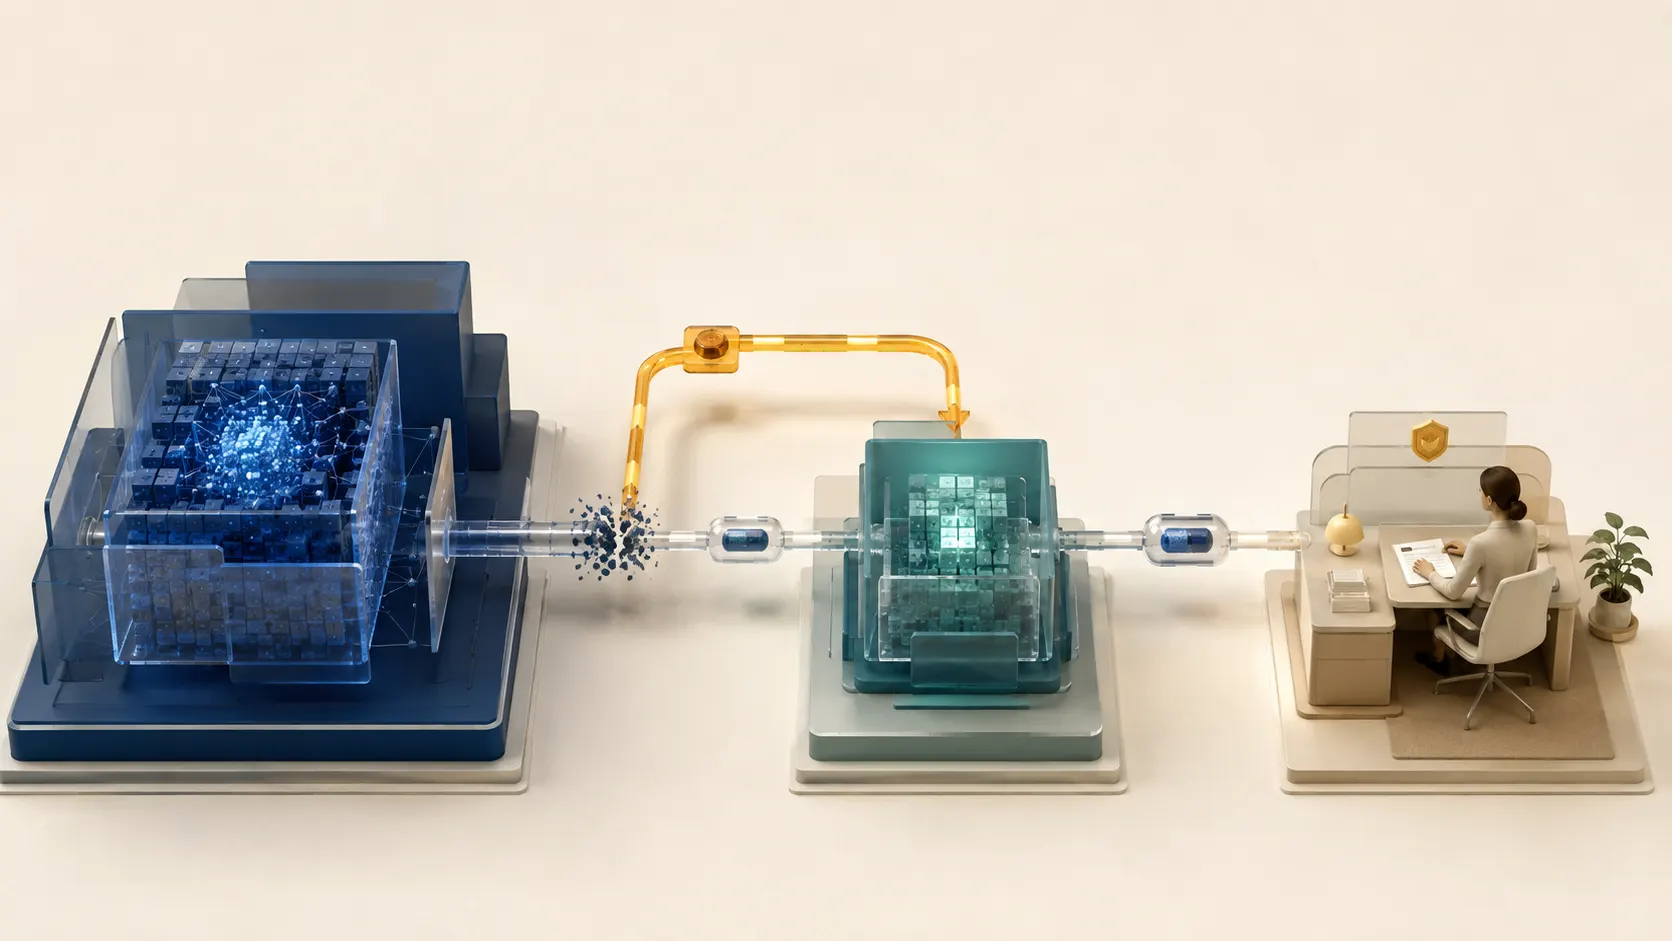
Представьте гипотетическую ситуацию: команда готовит клиентское предложение или изменение программной системы. Основная AI-модель становится недоступной посреди работы. Резерв отвечает, но пропускает ограничения, теряет важный факт и хуже справляется с планированием.
Для отдельного человека это означает задержку. Для компании сценарий задаёт более серьёзный вопрос: что произойдёт с процессом, если лучшая из доступных моделей исчезнет посреди задачи?
Наивный ответ — отправить тот же запрос другой нейросети. Но резервная модель может хуже рассуждать, слабее соблюдать ограничения, иначе вызывать инструменты, терять длинный контекст или не иметь доступа к нужным данным. Технически система продолжит отвечать. Операционно она уже будет другой.
Правильная цель — не «любой ответ любой ценой», а непрерывность приемлемой работы. При ухудшении модели должны плавно снижаться её полномочия, расти степень проверки и, если требуется, включаться человек. Контекст при этом должен принадлежать рабочему процессу, а не конкретному чату или провайдеру.
Доступность ответа ещё не означает доступность услуги
Обычный uptime отвечает на вопрос: вернул ли endpoint результат. Для AI-систем этого недостаточно. Полезно различать три уровня доступности.
Техническая доступность — запрос завершился в установленный срок, без сетевой ошибки, таймаута или отказа авторизации.
Семантическая доступность — результат достаточно качественен для конкретной задачи: факты подтверждены, формат соблюдён, инструменты вызваны корректно, существенные ограничения не потеряны.
Операционная доступность — результат можно безопасно использовать с тем уровнем полномочий, который система собирается ему дать.
Слабая резервная модель может обеспечить первый уровень, частично второй и не обеспечить третий. Поэтому полезная метрика должна считать не все HTTP 200, а только «хорошие завершения»:
Полезная доступность =
  завершения в срок, прошедшие качество, контекст и политику
  ------------------------------------------------
                 все допустимые запросы
Остановки и отложенные задачи учитываются отдельно: безопасный отказ не становится успешным завершением, если задача состояла в выполнении работы. Знаменатель и критерии полезного результата фиксируют до инцидента, чтобы не улучшать показатель исключением неудобных случаев.
Это продолжает логику SRE: Google рекомендует строить SLO вокруг измеримого пользовательского результата (откроется в новой вкладке), а не вокруг внутреннего ощущения, что сервис «вроде работает». Для AI к latency и error rate добавляется качество.
Почему автоматический failover может ухудшить аварию
Мировая практика распределённых систем давно предупреждает: редко используемый резервный путь часто ломается именно тогда, когда становится нужен.
Amazon Builders’ Library (откроется в новой вкладке) выделяет четыре стратегии реакции на критический сбой: retry, параллельную попытку, failover на другую копию и fallback на другой механизм. Авторы отдельно предупреждают, что fallback сложнее тестировать, он способен расширить зону поражения и увеличить время восстановления. Вывод не в том, что резерв запрещён. Вывод в том, что резерв нельзя считать надёжным, пока он не используется и не проверяется регулярно.
AI усиливает проблему по трём причинам.
Первая — ответы недетерминированы. Резерв может успешно обработать API-запрос и при этом незаметно нарушить бизнес-правило.
Вторая — модели не взаимозаменяемы. Исследования FrugalGPT (откроется в новой вкладке) и RouteLLM (откроется в новой вкладке) показывают ценность маршрутизации между более сильными и более слабыми моделями, но сама маршрутизация опирается на оценку того, какая модель справится с конкретным запросом. Простого списка приоритетов недостаточно.
Третья — модель часто находится внутри многошагового процесса. Если заново отправить ей только последнюю реплику, она не увидит принятые решения, уже выполненные действия, источники и незавершённые обязательства. Если отправить весь сырой чат, можно превысить контекст, перенести секреты или заставить другую модель неверно интерпретировать служебные сообщения и tool calls.
От резервной модели к резервному режиму
Надёжная система переключает не только модель. Она переключает операционный режим.
Предлагаемая авторская методика Methodfield называется AI Continuity Ladder — лестница непрерывности AI. Это наш прикладной синтез, а не стандарт ISO/NIST и не доказательство соответствия законодательству. У неё два встречных движения:
- чем ниже подтверждённая способность модели, тем меньше её право действовать;
- чем выше последствия ошибки и неопределённость контекста, тем сильнее контроль человека.
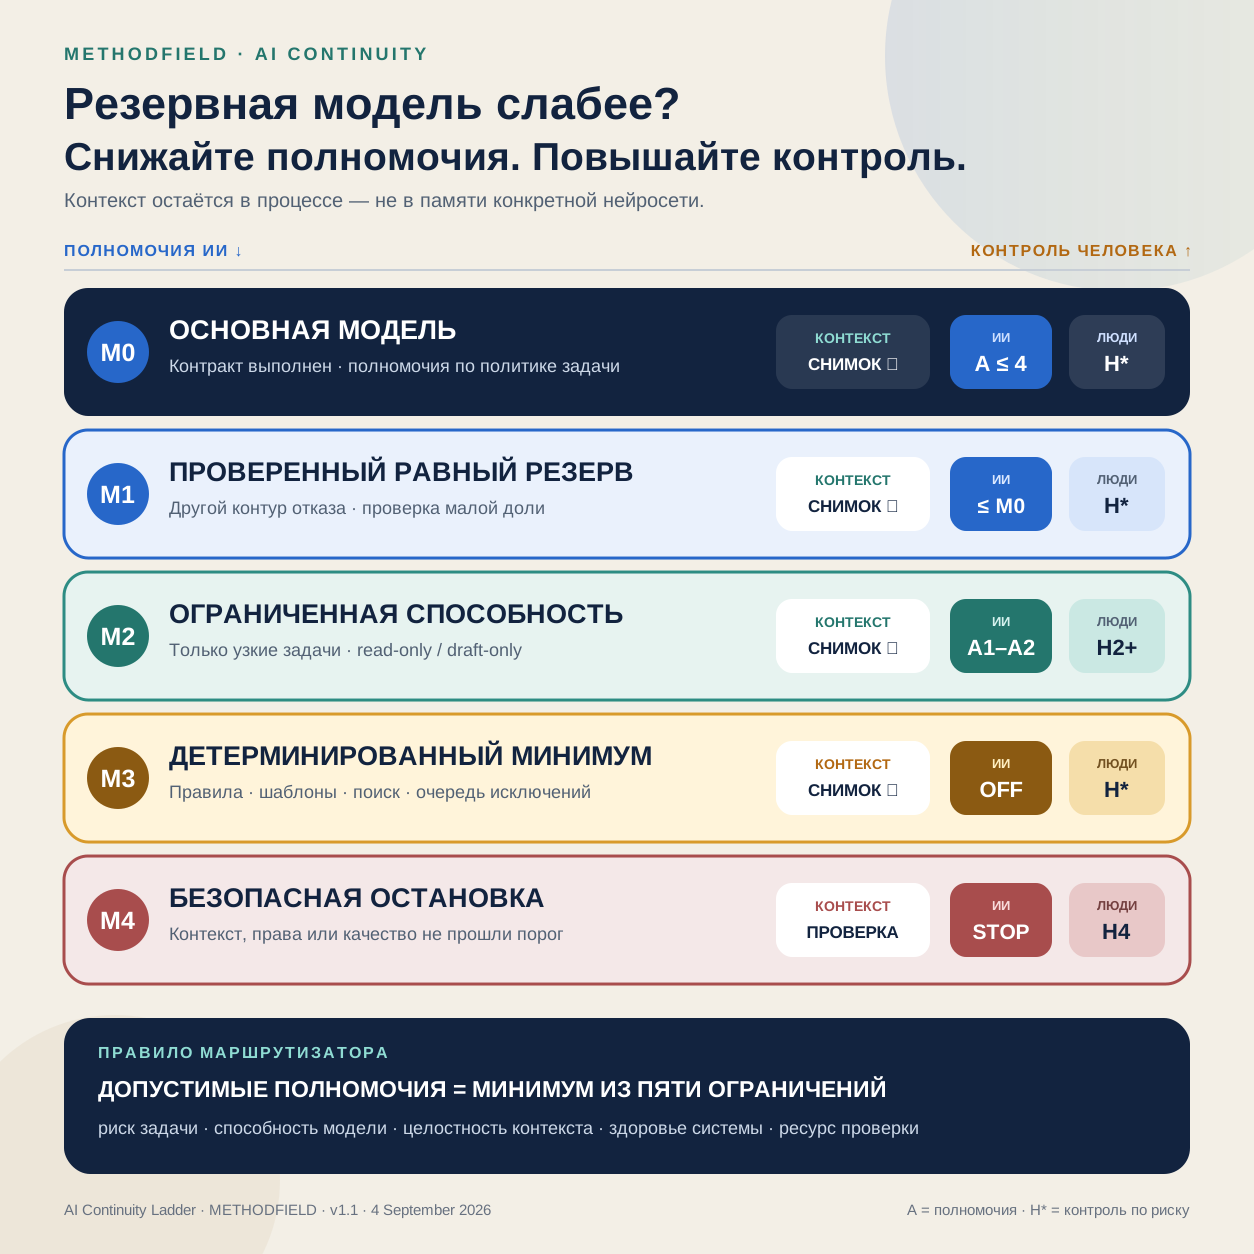
Режим 0. Основная модель
Основная модель здорова и проходит текущие проверки качества. Она работает с заранее установленным, а не максимальным уровнем автономности. Высокорисковые действия всё равно могут требовать утверждения.
Режим 1. Проверенный эквивалентный резерв
Система выбирает модель, которая на репрезентативном наборе задач достигла согласованного порога качества, поддерживает нужные инструменты, формат и политику данных. Первые запросы идут через canary, затем трафик повышается постепенно. Полномочия могут сохраниться либо снизиться на одну ступень, если данных о резерве меньше.
Режим 2. Модель с ограниченной подтверждённой способностью
Облачная или локальная модель проходит только более узкий контракт. Место размещения само по себе не определяет качество: проверенная локальная модель может быть и основным исполнителем, и эквивалентным резервом. Процесс продолжается, но AI переходит в read-only или draft-only: извлекает данные, сортирует, резюмирует, предлагает варианты. Любое внешнее сообщение, изменение записи, коммит, платёж или решение о человеке требует явного одобрения. Если локальная модель хорошо решает только классификацию и извлечение, ей не поручают сложное планирование «потому что больше некому».
Режим 3. Детерминированный минимум
Генеративная часть недоступна или не проходит порог. Система использует заранее подготовленные правила, шаблоны, поиск, кэш утверждённых ответов и обычную автоматизацию. Неоднозначные задачи ставятся в очередь. Пользователь получает честное сообщение о сокращённой функциональности.
Режим 4. Безопасная остановка
Контекст повреждён, личность или права не подтверждены, обязательные условия необратимого действия не выполнены либо ни одна разрешённая модель не достигает минимального качества. Система не продолжает угадывать: сохраняет состояние, блокирует новые последствия и передаёт задачу ответственному человеку.
Плавность не означает обязательного прохода через все ступени. Нарушение прав, целостности или критического ограничения немедленно переводит процесс в M4. Уровни контроля H0–H4 не являются строгой шкалой для всех режимов: в M3 надзор определяется риском детерминированного действия, а не номером режима.
Так деградация становится управляемой. Между «полностью автономно» и «ничего не работает» появляются полезные, заранее определённые состояния.
Контекст должен жить вне модели
Чтобы переключение не обнуляло работу, нужен переносимый Context Capsule — компактный снимок состояния. Это не копия внутреннего рассуждения модели и не бесконечный transcript. Это проверяемая запись того, что нужно следующему исполнителю.
Минимальная капсула содержит:
- идентификатор задачи, владельца и уровень критичности;
- цель и критерии завершения;
- подтверждённые факты со ссылками на источники;
- решения и имя того, кто их утвердил;
- ограничения, запрещённые действия и политику данных;
- уже выполненные tool calls, их результаты и idempotency keys;
- версии артефактов и хэши, чтобы не редактировать устаревший файл;
- открытые вопросы, риски и следующий безопасный шаг;
- модель, конфигурацию, время и результаты контрольных проверок.
Эта идея следует общей практике durable workflows: AWS Step Functions сохраняет состояние между шагами (откроется в новой вкладке). Важен принцип, а не конкретный продукт: workflow владеет состоянием, модель выполняет ограниченную операцию.
Открытые стандарты помогают снизить связанность, но не решают задачу целиком. CloudEvents (откроется в новой вкладке) унифицирует описание событий между платформами, W3C Trace Context (откроется в новой вкладке) — передачу идентификаторов распределённой трассировки, OpenTelemetry (откроется в новой вкладке) — общие поля для GenAI-телеметрии, а Model Context Protocol (откроется в новой вкладке) — обнаружение и вызов инструментов. Но бизнес-смысл решений, уровень полномочий и подтверждённые факты организация всё равно должна определить в собственной схеме.
Внешняя и внутренняя модель — разные компромиссы
У внешней модели можно получить нужные способности без собственной инфраструктуры, но пригодность проверяется на конкретных задачах. Цена — зависимость от сети, аккаунта, квот, политики провайдера и его обновлений. Нельзя выводить превосходство качества только из слова «облачная».
Внутренняя или self-hosted модель даёт больше контроля над данными, версией и доступностью внутри собственного контура. Но её качество, контекстное окно, tool use и способность работать на нескольких языках могут быть слабее. Кроме того, локальная модель добавляет собственные риски: дефицит GPU, обновления, мониторинг, безопасность весов и компетенции команды.
Поэтому выбор «external versus internal» нельзя сводить к идеологии. Практичная схема распределяет задачи:
- внешняя сильная модель — сложный анализ и генерация в разрешённом контуре;
- внутренняя модель — узкие, регулярно проверяемые операции: классификация, извлечение, редактирование по шаблону, поиск по локальным знаниям;
- детерминированный код — валидация, права, расчёты, запись состояния и применение последствий;
- человек — ответственность за исключения и решения с высокой ценой ошибки.
Внутренняя модель становится настоящим резервом только после capacity test, task evals и регулярного рабочего трафика. Запущенный однажды ноутбук с весами — не continuity architecture.
Маршрутизатор должен оценивать способность, а не бренд
У каждого AI-задания должен быть контракт способности. Он задаёт минимальные показатели для конкретной операции:
- точность и полнота;
- соблюдение инструкций и схемы ответа;
- корректность tool calls;
- привязка утверждений к источникам;
- нужный язык и терминология;
- latency и стоимость;
- допустимость обработки этих данных;
- устойчивость к типовым атакам и нежелательному поведению.
Перед включением новой модели неизменный набор заданий прогоняют на основной и резервной конфигурациях. Меняют по одному фактору и повторяют проверки. Документация Google Cloud (откроется в новой вкладке) описывает сравнение оценок модели-судьи с человеческими оценками. Это важное ограничение: LLM-as-a-judge полезен для масштаба, но не должен быть единственным источником истины.
Исследовательские роутеры и Amazon Bedrock Intelligent Prompt Routing (откроется в новой вкладке) показывают, что выбор модели можно делать на уровне отдельного запроса. Но готовый роутер оптимизирует только те критерии и семейства моделей, которые знает. Организации всё равно нужен собственный policy layer, учитывающий риск, данные и полномочия.
Полезное правило вычисляется так:
Допустимые полномочия = минимум из:
  политики задачи,
  подтверждённой способности модели,
  полноты контекста,
  текущего здоровья системы,
  доступной мощности человеческой проверки.
Модель никогда не должна сама повышать этот уровень.
Как сделать переключение плавным
У системы должны быть четыре группы сигналов.
- Транспортные: таймауты, 5xx, 429, ошибки DNS и авторизации, длина очереди.
- Семантические: нарушение схемы, рост неподтверждённых утверждений, ошибки инструментов, падение оценок на онлайн-примерах.
- Контекстные: отсутствующий checkpoint, несовпадение версии, недоступный источник, неполный журнал действий.
- Операционные: риск задачи, обратимость действия, близость к клиенту, чувствительность данных.
Retry допустим для классифицированных временных ошибок, если операция идемпотентна. AWS Well-Architected (откроется в новой вкладке) рекомендует ограничивать число повторов, применять exponential backoff с jitter и не повторять ошибки прав или конфигурации, которые сами не исчезнут. Неограниченные повторы превращают локальный сбой в retry storm; Google SRE (откроется в новой вкладке) показывает, как такие повторы усиливают перегрузку.
После порога временных ошибок circuit breaker блокирует новые обращения к неисправной зависимости и выбирает допустимый резервный режим. Ошибка авторизации, повреждённый контекст или критическое нарушение политики блокируют соответствующее действие сразу, без ожидания общего порога. Возврат идёт через half-open probes и небольшой canary. Нужен гистерезис: переключиться можно быстро, но вернуться к полной автономности — только после окна стабильности и успешного сравнения результатов. Иначе система начнёт метаться между моделями.
Человек — не декоративная кнопка Approve
Рост контроля не должен означать, что оператор получает непрозрачный текст и автоматически нажимает «подтвердить». Он должен видеть:
- предлагаемое действие и его последствия;
- факты и источники, на которых оно основано;
- что изменила резервная модель;
- её известные ограничения и текущий режим;
- расхождения между основной, резервной и детерминированной проверкой;
- approve, edit, reject и безопасную остановку.
Добровольная рамка NIST AI RMF (откроется в новой вкладке) рекомендует определять роли human-AI oversight, регулярно измерять поведение системы и проектировать безопасный отказ. Человеческий контроль должен быть соразмерен последствиям и иметь реальное право отказать или остановить процесс. Применимость требований к регулируемым и высокорисковым системам проверяют отдельно с профильными специалистами; эта статья не является юридическим заключением.
Планирование начинается с бизнес-процесса
ISO 22301 (откроется в новой вкладке) рассматривает continuity как управленческую систему: понять контекст, подготовиться, реагировать, восстанавливаться и постоянно улучшать. NIST SP 800-34 Rev. 1 (откроется в новой вкладке) начинает с business impact analysis и связывает стратегию восстановления с уровнем воздействия.
Для каждого AI-зависимого процесса полезно определить:
- максимальный допустимый период без этой функции;
- RTO-AI — через какое время должен появиться приемлемый, пусть и упрощённый режим;
- RPO-context — сколько подтверждённого состояния можно потерять;
- минимальную полезную мощность в деградированном режиме;
- задачи, которые можно поставить в очередь;
- действия, которые нельзя выполнять без сильной модели или человека;
- владельца решения о смене режима и канал связи с пользователями.
У низкорискового редакционного процесса нормальным резервом может быть сохранение черновика и перенос срока. Для ответа клиенту — утверждённый шаблон и очередь оператору. Для платежа, найма, медицинской рекомендации или критического кода правильным режимом часто будет остановка, а не «похожий ответ» более слабой модели.
Runbook инцидента
Когда провайдер уже недоступен, команда не должна проектировать резерв на ходу.
- Классифицировать отказ: transient, throttling, auth/configuration, provider outage, semantic regression или потеря контекста.
- Зафиксировать checkpoint и приостановить новые необратимые действия.
- Ограничить повторы по единому retry budget; не позволять каждому слою повторять независимо.
- Проверить реальную независимость резерва: провайдер, облако, регион, identity, gateway, хранилище контекста и сеть.
- Выбрать только заранее утверждённый режим и перенести Context Capsule.
- Выполнить canary на нескольких репрезентативных задачах, включая формат, факты и tool calls.
- Установить новый предел полномочий и включить соответствующую очередь человеческой проверки.
- Сообщить пользователю, какая функциональность ограничена и что будет с уже начатой работой.
- При восстановлении вернуть трафик постепенно, сверить дубликаты и незавершённые действия по idempotency keys.
- Провести разбор без поиска виноватого: какие сигналы запоздали, где потерялся контекст, выдержал ли резерв качество и была ли нагрузка на людей реалистична.
Тестировать нужно отказ качества, а не только timeout
Обычный chaos test отключает endpoint. AI-continuity test должен также подменять сильную модель слабой и проверять, сокращаются ли полномочия автоматически.
Principles of Chaos Engineering (откроется в новой вкладке) предлагает сначала определить steady state, затем ввести реалистичный сбой и искать отклонение при ограниченном blast radius. AWS Well-Architected (откроется в новой вкладке) рекомендует регулярные game days с участием технических и бизнес-владельцев.
Для AI-систем полезны по меньшей мере шесть сценариев:
- основной endpoint возвращает 5xx;
- latency выходит за дедлайн;
- квота исчерпана;
- модель отвечает, но перестаёт соблюдать JSON-схему;
- резервная модель теряет один критический факт из контекста;
- human queue переполняется после автоматического снижения автономности.
Последний сценарий часто забывают. Нельзя назвать систему устойчивой, если при отказе модели она создаёт объём ручной проверки, который команда физически не может обработать.
Что не работает
Одинаковый prompt для всех моделей. Инструкции, tool schemas и длина контекста переносятся не буквально. Нужен общий контракт и адаптеры.
Автоматическое переключение только по 5xx. Модель может деградировать семантически при полностью здоровом API.
Полный transcript как состояние. Он дорог, содержит шум и секреты, плохо показывает принятые решения и выполненные последствия.
Локальная модель как талисман независимости. Без capacity test, обновлений, evals и регулярной эксплуатации она является прототипом, а не резервом.
Резерв через тот же failure domain. Другой model ID за тем же gateway, аккаунтом, регионом и хранилищем не защищает от общего отказа.
Мгновенный failback. Возврат полной автономности сразу после первого успешного запроса создаёт flapping и повторные ошибки.
Человек без времени и доказательств. Human-in-the-loop не работает, если очередь превышает пропускную способность или интерфейс провоцирует rubber-stamping.
Как продолжить личную работу и разработку
Если вы работаете в чатах, а не строите AI-платформу, достаточно небольшого файла передачи: цель, ограничения, решения, подтверждённые источники, ссылки на артефакты и следующий шаг. Сохраняйте его регулярно в разрешённом рабочем хранилище, доступном без основного AI-сервиса.
При сбое сначала проверьте, какие изменения уже произошли. Передайте резерву только разрешённые данные и узкую задачу. Для разработки сохраните ветку, diff, результаты тестов и список незавершённого; начните с объяснения кода, тестов или черновика патча. Не переносите автоматически право на merge, deploy, изменение схемы или секретов. Эти действия должны пройти обычные проверки и утверждения.
Если резерв не справляется, переключитесь на чтение документации, ручной анализ, тестирование или согласуйте перенос срока. Копирование всего чата в случайный сервис не является безопасным восстановлением.
Минимальный план на 30 дней
Неделя 1. Инвентаризация. Найти все процессы, где AI находится на критическом пути. Для каждого указать владельца, последствия ошибки, данные, внешние зависимости и максимально допустимый перерыв.
Неделя 2. Контракты и контекст. Создать task-specific eval set и схему Context Capsule. Отделить состояние и права от prompt. Ввести idempotency keys для внешних действий.
Неделя 3. Режимы. Настроить одну эквивалентную либо более слабую резервную модель, детерминированный минимум и human queue. Прописать автоматическое снижение полномочий.
Неделя 4. Учение. Отключить основной endpoint, ухудшить ответы резерва, измерить RTO-AI, RPO-context, полезную доступность, размер очереди и время человеческого решения. Исправить найденное и назначить следующую дату учения.
Главное правило
Сильная модель может исчезнуть. Контекст, ограничения и ответственность исчезать не должны.
Надёжная AI-система не обещает, что любая нейросеть заменит любую другую. Она честно знает, что умеет каждый исполнитель; хранит состояние вне него; уменьшает свободу действий быстрее, чем падает качество; и вовремя передаёт решение человеку.
Это не отказ от автономности. Это условие, при котором автономности вообще можно доверять.
Подробная версия для внедрения — матрицы, пример записи Context Capsule, показатели и сценарий учения — находится в методике AI Continuity Ladder. Пример JSON не заменяет исполняемую схему и проверки конкретной реализации.
Связанные материалы
Перейдите к оценке AI-систем перед выпуском, контролю полномочий агента и владению системой после запуска. Вместе они связывают доказанное качество, право действовать и восстановление.
Первичные источники приведены рядом с утверждениями. Проверка ссылок и редакционная адаптация: 4 сентября 2026 года. Исследования маршрутизации подтверждают различия моделей и возможность выбора исполнителя, но сами по себе не доказывают надёжность резервирования при аварии.
Источники
Первичные источники связаны с утверждениями в тексте. Основные опорные материалы: