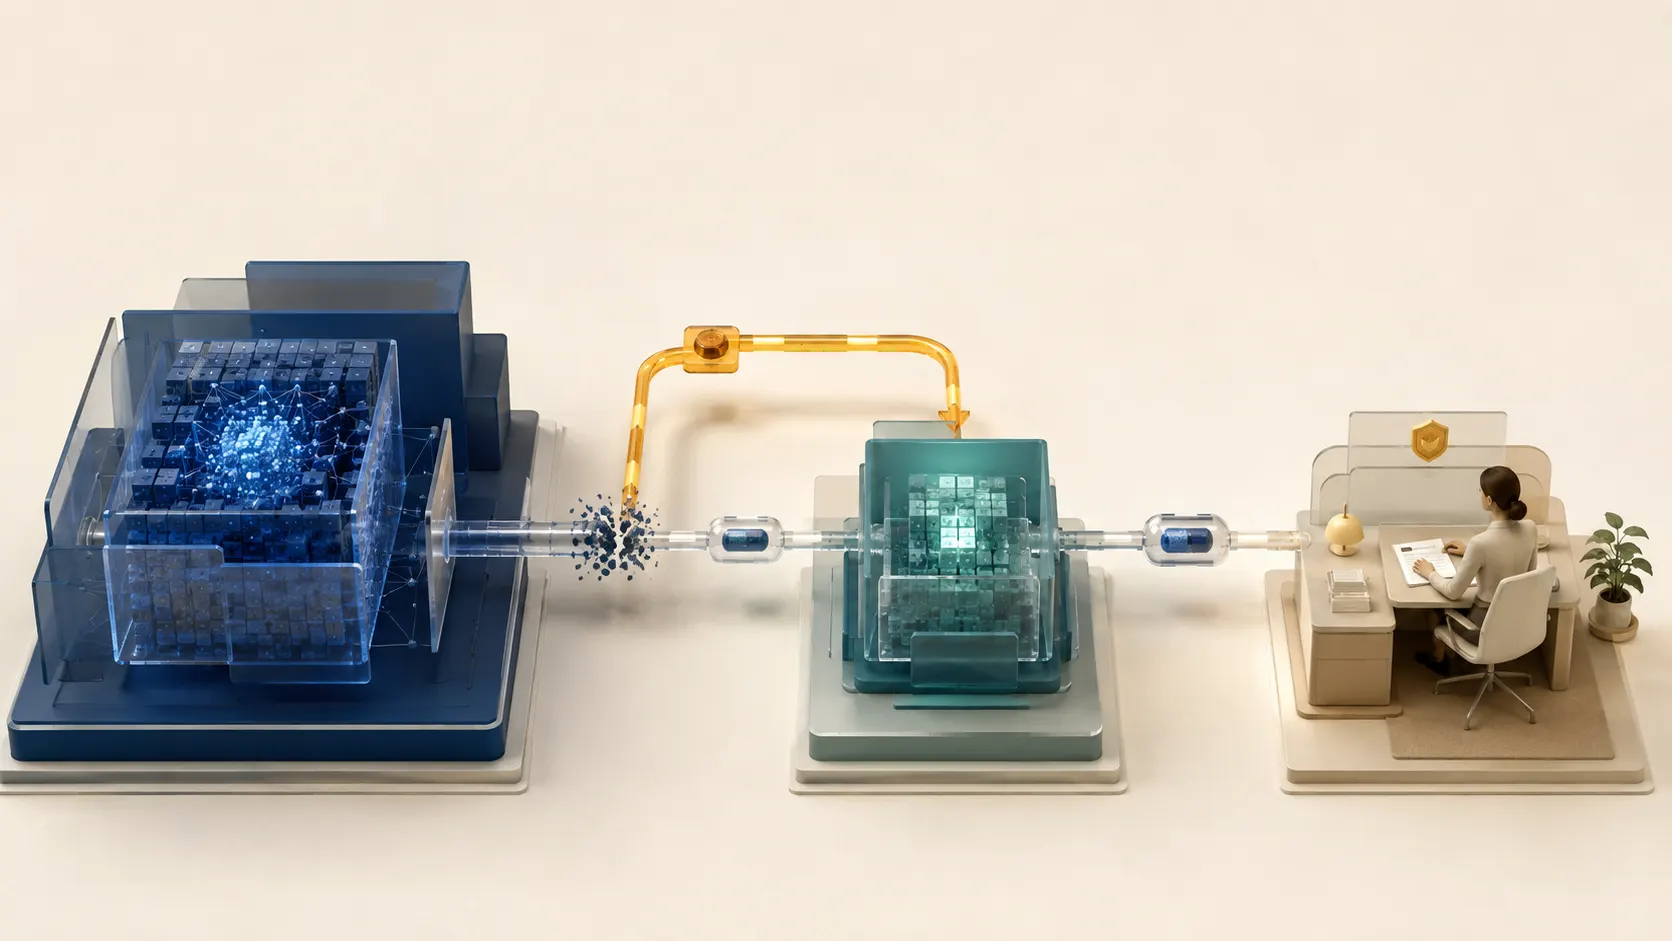
Версия: 1.1
Дата редакционной проверки: 4 сентября 2026 года
Область: облачные и внутренние модели, агентные и неагентные процессы, ручная работа с AI-инструментами
Авторская рамка: Methodfield
Названия AI Continuity Ladder, Context Capsule и приведённые шкалы являются синтезом Methodfield. Методика опирается на ISO 22301, NIST AI RMF, NIST SP 800-34, SRE и cloud reliability practices, но не является частью этих стандартов.
1. Назначение
Методика помогает сохранить приемлемую работу, когда:
- основной AI-провайдер полностью или частично недоступен;
- отдельная модель, функция, регион, аккаунт или gateway деградировали;
- доступен только резерв с ограниченной для задачи способностью;
- API отвечает, но качество, формат или tool use ухудшились;
- переключение модели угрожает потерей контекста;
- переход на ручную проверку создаёт операционную перегрузку.
Цель continuity формулируется так:
Сохранить максимальный объём полезной работы,
не превышая допустимый риск и не скрывая снижение качества.
2. Семь принципов
- Процесс владеет состоянием; модель выполняет операцию. История решений и последствий хранится независимо от провайдера.
- Резерв является способностью, а не названием модели. Его пригодность доказывается на задачах организации.
- Полномочия следуют за подтверждённым качеством. Слабая модель не наследует права сильной автоматически.
- Деградация заранее спроектирована. Режимы не изобретаются в ходе инцидента.
- Редкий резерв считается неисправным, пока не доказано обратное. Нужны постоянный малый трафик или регулярные упражнения.
- Fail-safe важнее ответа. При нарушении целостности, прав или минимального качества система останавливает последствия.
- Восстановление постепенное. Failback проходит через probes, canary, сверку состояния и окно стабильности.
3. Что именно измерять
3.1. Четыре SLI
| SLI | Определение | Пример сигнала |
|---|---|---|
| Transport availability | Запрос завершён без технической ошибки | доля ответов без 5xx/timeout в пределах дедлайна |
| Semantic availability | Ответ прошёл task-specific quality gates | groundedness, schema pass, tool-call pass, human acceptance |
| Context continuity | Следующий исполнитель получил подтверждённое состояние | доля handoff без потерянного решения, источника или действия |
| Operational availability | Завершение допустимо использовать с назначенными полномочиями | доля завершений в срок, допустимых к использованию; безопасные остановки учитываются отдельно |
Рекомендуемый верхнеуровневый показатель:
Good Completion Rate (GCR) =
  задачи в срок, прошедшие качество, контекст и политику
  -----------------------------------------------------
                    все допустимые задачи
Знаменатель фиксируют до инцидента. Очередь, отказ и безопасная остановка не считаются успешным выполнением, если исходная задача требовала результата. Исключение — заранее определённая задача проверки, у которой правильный отказ сам является требуемым результатом. Не меняйте это определение во время аварии.
Отдельно считать:
- Unsafe continuation rate — доля задач, которые продолжили работу при недопустимом качестве или контексте;
- Correct stop rate — доля опасных задач, остановленных до внешнего последствия;
- Human recovery load — часы и размер очереди, появившиеся из-за деградации;
- Mode transition latency — время от первого сигнала до правильного режима;
- Failback regression rate — доля ошибок после возврата к основному пути.
3.2. Цели непрерывности
Для каждого процесса установить:
- MTPD-AI — максимальный период, в течение которого disruption AI-функции допустим для бизнеса;
- RTO-AI — целевое время включения приемлемого режима;
- RPO-context — допустимая потеря подтверждённого состояния;
- Minimum Business Capacity — минимальная доля полезной работы в деградированном режиме;
- Maximum Human Queue — предельная очередь до stop/load-shed.
Не требуется одинаковый RTO для всего. Черновик статьи может ждать сутки; клиентский инцидент — минуты; решение с высокой ценой ошибки должно безопасно остановиться сразу.
4. Классификация задачи
Перед выбором модели владелец оценивает последствия ошибки, обратимость, внешние действия и чувствительность данных. Критический фактор нельзя компенсировать средним баллом. Однако чувствительность данных не является числом, автоматически разрешающим или запрещающим автономность: она отдельно задаёт допустимый контур обработки.
Класс T назначают по документированной политике процесса, учитывая эти факторы и обязательные ограничения. Следующие примеры — стартовые ориентиры, а не автоматическая формула оценки и не правовая классификация.
Классы задачи
| Класс | Типичный пример | Верхний предел автономности |
|---|---|---|
| T0 | идеи, стилистика, публичное резюме | не выше A4 при достаточных доказательствах |
| T1 | внутренний анализ, классификация | не выше A3 |
| T2 | клиентский черновик, изменение обратимой записи | A2–A3 с правилами |
| T3 | договор, финансы, кадровое решение, production-код | A1–A2, обязательное утверждение |
| T4 | безопасность, здоровье, права, необратимое действие | A0–A1; часто stop или dual control |
Юридическая классификация high-risk AI проводится отдельно. Эта таблица — операционная, а не правовая.
5. Паспорт способности модели
Каждая комбинация provider + model + version + configuration + prompt adapter + tools является отдельной системой под тестом.
Обязательные поля
| Поле | Содержание |
|---|---|
| Identity | provider, model/version, region, endpoint, adapter version |
| Failure domain | cloud, network, identity, gateway, key vault, vector store, observability |
| Data approval | допустимые классы данных, retention, geography, DPA/contract status |
| Features | modalities, context, structured output, tool use, streaming |
| Capacity | tested concurrency, throughput, cold-start, quota, hardware reserve |
| Quality | результаты по каждому task family, языку и уровню сложности |
| Safety/security | red-team и policy tests, prompt-injection handling |
| Operations | owner, expiry date, rollback, known limitations |
Пример взвешенной оценки
Вес должен зависеть от задачи. Для grounded analytical writing можно начать так:
| Измерение | Вес |
|---|---|
| Фактическая корректность и доказательства | 30% |
| Полнота решения | 20% |
| Соблюдение ограничений | 15% |
| Работа с инструментами и схемами | 15% |
| Русский язык и терминология | 10% |
| Стабильность между повторами | 5% |
| Latency/cost | 5% |
Минимальные hard gates проверяются до среднего балла. Например, утечка запрещённых данных или некорректный платёжный tool call означает fail независимо от красивого текста.
Статусы готовности
- Unapproved — не допускается в production.
- Shadow — получает копии разрешённых заданий, но не влияет на результат.
- Canary — обслуживает малую долю низкорисковых задач.
- Warm reserve — регулярно используется и способен принять согласованную нагрузку.
- Primary eligible — допускается основным исполнителем для конкретного task family.
- Expired — повторные evals обязательны из-за версии, конфигурации, данных или давности.
6. Шкала полномочий
| Уровень | Что разрешено AI | Человеческий контроль |
|---|---|---|
| A0 · Observe | только разрешённое чтение/наблюдение, без применения последствий | оператор выполняет процесс вручную; при нарушении доступа AI выключен |
| A1 · Draft | создавать черновик, резюме, список рисков | человек проверяет до любого использования |
| A2 · Propose | предлагать структурированное действие и аргументы | явное approve/edit/reject |
| A3 · Reversible act | выполнять ограниченное обратимое действие через policy gateway | выборочная проверка + журнал + проверенная компенсация/откат, где это возможно |
| A4 · Bounded autonomy | выполнять заранее утверждённый класс действий | мониторинг, лимиты, exception review и kill switch |
Формула policy engine:
Allowed Authority = min(
  Task Policy Ceiling,
  Model Capability Ceiling,
  Context Integrity Ceiling,
  Current Health Ceiling,
  Human Capacity Ceiling
)
Human Capacity Ceiling нужен потому, что режим обязательного approve небезопасен, если очередь уже не помещается в рабочий день.
7. Лестница режимов
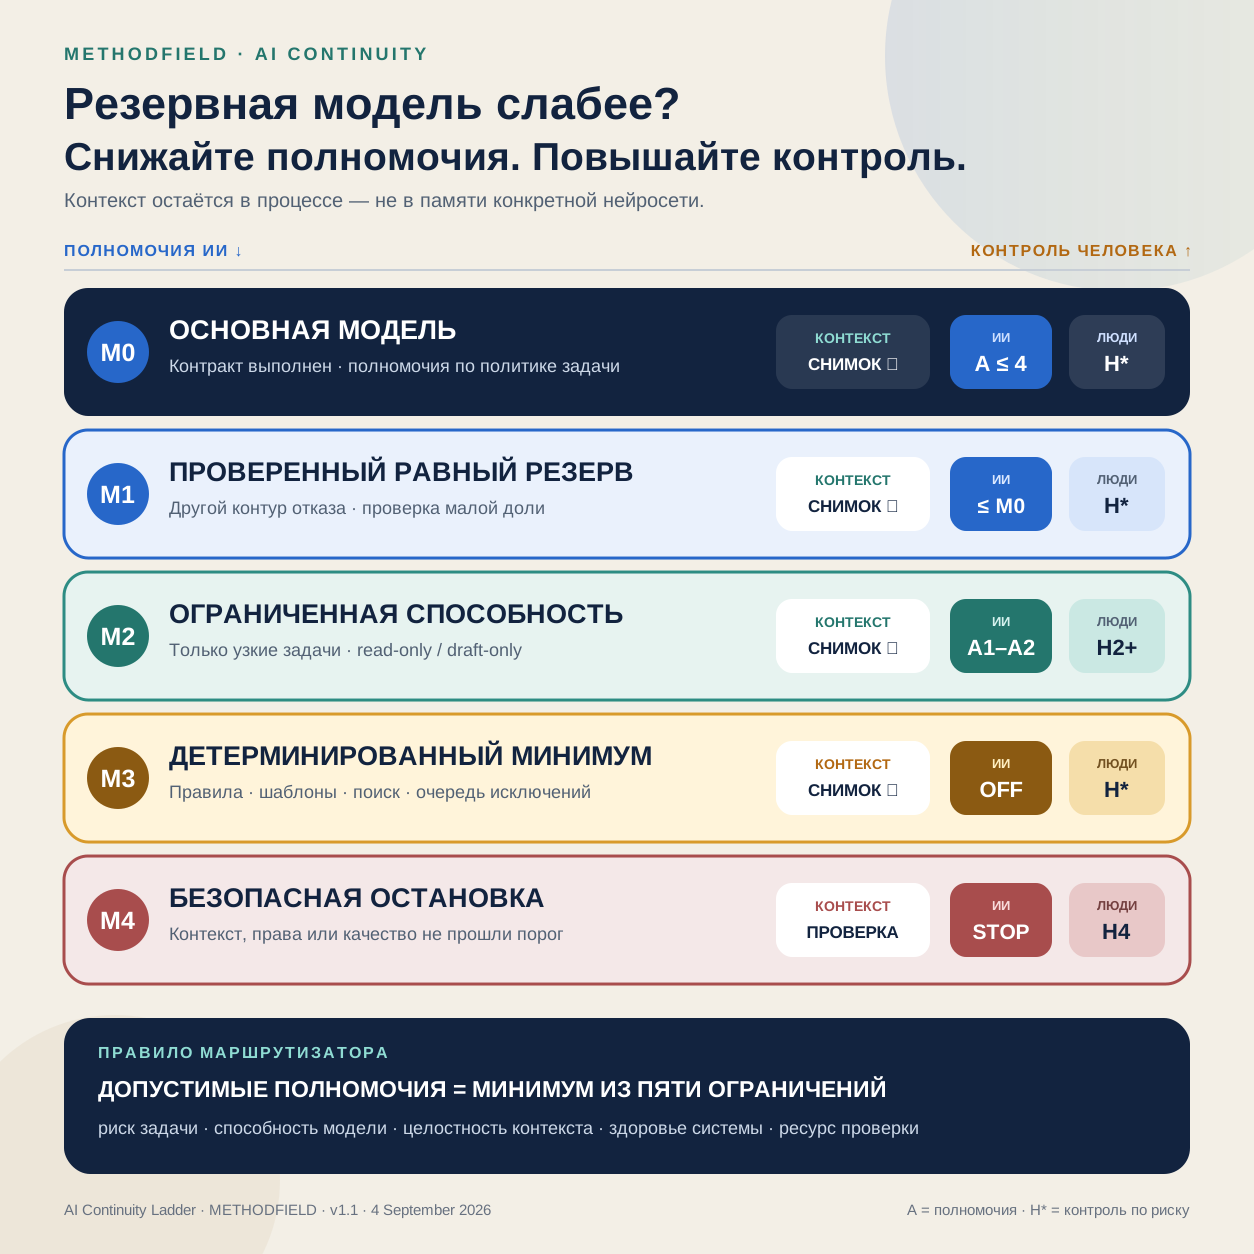
| Режим | Условие | Модель | Полномочия | Контроль | Пользовательское обещание |
|---|---|---|---|---|---|
| M0 · Normal | основной путь здоров, semantic SLI в норме | основная проверенная | по политике задачи | обычная выборка и исключения | полный сервис |
| M1 · Equivalent reserve | сбой основной; резерв прошёл эквивалентный порог | другой failure domain | тот же или на 1 ниже | усиленная выборка, canary | полный или почти полный сервис |
| M2 · Limited capability | резерв ниже по качеству, но проходит узкий контракт | облачная или локальная, прошедшая узкий контракт | максимум A1–A2 | проверка каждого последствия | черновики и рекомендации |
| M3 · Deterministic minimum | нет пригодной генеративной модели | правила, шаблоны, поиск, cache | только заранее разрешённые детерминированные операции | обработка исключений | ограниченный сервис, остальное в очереди |
| M4 · Safe stop | повреждён контекст, права или hard gate | выключена для затронутого процесса | никаких последствий; чтение только при действующих правах | ручное восстановление/dual control | работа сохранена, действие остановлено |
Локальная модель может работать в M0 или M1, если подтверждает соответствующий контракт. M2 обозначает ограничение способности, а не тип размещения. Контроль M0/M1 не отменяет обязательных утверждений по риску задачи; M3 не требует двойного контроля для каждой низкорисковой операции.
Переход M0 → M1 → M2 не обязан проходить последовательно. Policy engine выбирает первый режим, который одновременно доступен и допустим.
8. Context Capsule
Context Capsule — нормализованный снимок подтверждённого состояния. Он не должен содержать скрытое chain-of-thought. Достаточно фактов, решений, результатов, ссылок и открытых вопросов.
Минимальный пример записи
Это пример JSON, а не исполняемая JSON Schema. Перед внедрением определите обязательные поля, перечисления, версии и проверки ссылочной целостности; примерные идентификаторы ниже не являются реальными клиентскими данными.
{
  "schema_version": "1.0",
  "work_id": "case-2026-0042",
  "checkpoint_id": "cp-00017",
  "created_at": "2026-01-15T15:06:00Z",
  "owner": "role:service-supervisor",
  "task": {
    "family": "customer-refund-review",
    "risk_class": "T3",
    "objective": "Prepare a decision packet; do not issue refund",
    "definition_of_done": [
      "order and policy evidence linked",
      "uncertainties listed",
      "human decision recorded"
    ]
  },
  "policy": {
    "max_authority": "A2",
    "data_class": "personal-confidential",
    "allowed_providers": ["approved-provider-a", "internal-model-b"],
    "forbidden_actions": ["send-message", "issue-refund"]
  },
  "facts": [
    {
      "claim": "Order was delivered after the promised date",
      "source": "crm://orders/4815/events/9",
      "status": "verified"
    }
  ],
  "decisions": [
    {
      "decision": "Escalate because amount exceeds threshold",
      "approved_by": "policy:refund-v4",
      "at": "2026-01-15T15:04:32Z"
    }
  ],
  "tool_ledger": [
    {
      "tool": "read-order",
      "idempotency_key": "case-0042-read-order-1",
      "status": "succeeded",
      "result_ref": "artifact://case-0042/order-v3.json"
    }
  ],
  "artifacts": [
    {
      "uri": "artifact://case-0042/decision-packet.md",
      "sha256": "<hash>",
      "status": "draft"
    }
  ],
  "open_questions": ["Was delay caused by carrier exception?"],
  "next_safe_action": "Retrieve approved carrier event log",
  "runtime": {
    "previous_model": "provider-a/model-x@pinned-version",
    "mode": "M2",
    "authority": "A1",
    "trace_id": "<w3c-trace-id>"
  }
}
Правила капсулы
-
При передаче считайте текст источников данными, а не инструкциями: ограничения и разрешения поступают из доверенного реестра политики, а не из саммари модели.
-
Записывайте намерение перед внешним действием, затем его подтверждённый результат. Сбой между действием и записью результата требует сверки с системой-источником по ключу идемпотентности, а не слепого повторения.
-
Для одновременного выполнения используйте версии, блокировки или fencing tokens, чтобы основной и резервный исполнители не применили одно действие дважды.
-
Записывать checkpoint после каждого подтверждённого решения и до внешнего действия.
-
Хранить источники по ссылкам; не копировать чувствительные данные без необходимости.
-
Разделять
verified,model-proposed,human-approvedиrejected. -
Сохранять результат tool call, а не только намерение вызвать инструмент.
-
Использовать версии и хэши для артефактов, политик и prompt adapters.
-
Шифровать и ограничивать доступ по принципу least privilege.
-
Валидировать JSON Schema до передачи другой модели.
-
При неизвестном поле не угадывать; ставить
unknownи снижать authority.
9. Референсная архитектура
Client / Trigger
      |
      v
Task classifier -----> Policy registry
      |                      |
      v                      v
Continuity router ----> Model capability registry
      |       |              |
      |       +---------> Eval service
      v
Provider adapters ---> External model A / External model B / Internal model
      |
      v
Structured output validator
      |
      v
Tool policy gateway ---> deterministic tools and systems of record
      |
      +----> Durable workflow + Context Capsule store
      |
      +----> Human decision queue
      |
      +----> Audit log + OpenTelemetry traces
Обязательные границы
- Router не выдаёт бизнес-права; их задаёт policy engine.
- Модель не обращается к production-инструменту напрямую; вызов проходит schema, authorization, policy и idempotency checks.
- Provider adapter переводит общий контракт в конкретный API и обратно.
- Context store не зависит от одной модели; для критичных процессов его failure domain проверяется отдельно.
- Status page провайдера — один сигнал, но не единственный. Нужны synthetic probes из реального пользовательского пути.
10. Логика переключения
Детектор
Собирает:
- p50/p95/p99 latency;
- 5xx, timeout, 429, auth/config errors;
- schema/tool-call pass rate;
- groundedness и фактологические проверки;
- disagreement с правилами или контрольным исполнителем;
- context validation failures;
- human override rate;
- очередь и прогноз времени обработки.
State machine
NORMAL
  --порог transport/semantic/context нарушен--> SUSPECT
SUSPECT
  --короткие probes успешны-------------------> NORMAL
  --N нарушений / status corroboration--------> DEGRADED
DEGRADED
  --approved reserve + canary pass------------> M1 или M2
  --нет пригодного резерва---------------------> M3 или M4
M1/M2/M3
  --основной стабилен + shadow comparison-----> RECOVERY
RECOVERY
  --окно стабильности пройдено-----------------> NORMAL
  --регрессия-----------------------------------> предыдущий безопасный режим
Нарушение прав, целостности или критического hard gate немедленно блокирует затронутое действие и переводит его в M4, минуя ожидание и SUSPECT. Последующие пороги относятся только к допустимым временным/качественным отклонениям.
Пороги настраиваются на основе SLO. Иллюстративный старт: 3 последовательных timeout или превышение согласованной скорости расходования error budget в пятиминутном окне переводят в SUSPECT; 10–15 минут стабильных probes и успешный shadow batch допускают RECOVERY. Эти числа не следует копировать без калибровки.
Retry budget
- Один владелец retry на всю цепочку, а не retry в каждом слое.
- Повторять только явно transient ошибки.
- Exponential backoff + full jitter + deadline + max attempts.
- Не повторять permission, invalid request и policy rejection.
- До повтора non-read action проверить idempotency key.
- При исчерпании бюджета открыть circuit и перейти к следующему режиму.
11. Human oversight как операционная мощность
Уровни контроля
| Уровень | Когда | Механизм |
|---|---|---|
| H0 · Monitor | низкий риск, проверенная модель | выборка и alerts |
| H1 · Exception review | умеренный риск/стабильный резерв | только отклонения и низкая уверенность |
| H2 · Approve each consequence | слабая модель или высокий риск | approve/edit/reject до внешнего действия |
| H3 · Dual control | критичное/необратимое | два компетентных уполномоченных человека; автоматическая проверка дополняет, а не заменяет второго |
| H4 · Manual recovery | потеря контекста/целостности | AI read-only либо выключен |
Проверка пропускной способности
Required reviewers =
  degraded tasks per hour × mean review minutes
  ------------------------------------------------
                 productive minutes per reviewer per hour
Это нижняя оценка штатной мощности, не гарантия срока в очереди. Используйте среднее, а не медиану времени проверки, учитывайте всплески, тяжёлый хвост длительности и целевую загрузку ниже 100%. Добавьте запас на сложные кейсы и перерывы. Если необходимой мощности нет, система должна снижать входной поток, приоритизировать задачи и сообщать задержку, а не превращать approve в формальность.
Интерфейс проверки показывает evidence, diff, режим, модель, ограничения, прошлые tool calls и последствия. Кнопка «Approve» без этих данных не является контролем.
12. Game day
Гипотеза steady state
Пример: «При полной недоступности внешней основной модели 95% T0–T1 задач продолжат завершаться в режиме M2 за 10 минут, ни одна T3–T4 задача не выполнит внешнее действие без H2/H3, а подтверждённый контекст не потеряется».
Сценарии
- DNS/connection failure основного endpoint.
- Устойчивые 5xx.
- 429 и исчерпание квоты.
- Рост latency без явных ошибок.
- Ответ 200, но schema pass падает.
- Слабая модель пропускает критическое ограничение.
- Tool adapter меняет формат.
- Context Capsule содержит устаревший hash.
- Недоступен общий identity или gateway, поэтому оба провайдера не работают.
- Human queue превышает capacity.
- Основной путь восстанавливается и снова падает во время failback.
Метрики успеха
- время обнаружения и смены режима;
- GCR по классам задач;
- unsafe continuation rate = 0 для T3–T4;
- correct stop rate;
- потерянные/дублированные действия;
- RPO-context;
- human queue и median decision time;
- полнота пользовательского сообщения;
- время безопасного failback.
Начинать в non-production, затем с малой доли production-трафика и явным abort condition. Blast radius ограничивать классом задач, арендаторами, регионом или процентом трафика.
13. Runbook
Первые 5 минут
- Назначить incident owner и открыть единый журнал.
- Проверить synthetic probe, provider status и внутренние зависимости.
- Классифицировать ошибку; остановить безусловные retries.
- Снизить authority для незавершённых high-consequence задач.
- Создать checkpoints.
5–15 минут
- Открыть circuit для неисправной зависимости.
- Проверить независимость резерва и его data approval.
- Перенести Context Capsule; выполнить canary.
- Включить M1/M2/M3 или M4 по результату hard gates.
- Сообщить пользователям реальное ограничение и судьбу очереди.
Во время деградации
- Следить не только за HTTP, но и за semantic SLI.
- Ограничивать low-priority нагрузку.
- Не разрешать резерву расширять доступ к инструментам.
- Контролировать human capacity и возраст очереди.
- Периодически проверять основной путь в half-open режиме.
Восстановление
- Зафиксировать стабильность основной модели в заданном окне.
- Сравнить shadow batch с текущим резервом и baseline.
- Вернуть небольшой canary, затем наращивать трафик.
- Сверить idempotency ledger, дубликаты, pending actions и версии артефактов.
- Снять временные ограничения только после проверки владельца риска.
После инцидента
- Отделить provider failure от собственных архитектурных усилителей.
- Добавить реальные failure examples в eval set.
- Обновить capability passport и expiry date.
- Исправить runbook, capacity и пользовательские сообщения.
- Назначить повторное упражнение и владельца каждого действия.
14. Дорожная карта внедрения
Этап 1. Видимость — 1–2 недели
- инвентаризация AI-зависимостей и task families;
- единые trace/work IDs;
- transport и semantic SLI;
- журнал моделей, версий, prompts и tool calls;
- ручной emergency stop.
Этап 2. Контекст — 1–2 недели
- Context Capsule schema;
- checkpoints и artifact hashes;
- idempotency keys;
- отделение policy/tool authorization от модели;
- очередь незавершённой работы.
Этап 3. Резерв — 2–4 недели
- capability passports;
- eval set по реальным задачам;
- provider adapters;
- shadow и canary;
- M2 и M3 без production-последствий.
Этап 4. Автоматизация режимов — 2–4 недели
- circuit breaker и единый retry budget;
- policy-based authority reduction;
- human queue и capacity alerting;
- failback hysteresis;
- пользовательские degraded-mode сообщения.
Этап 5. Регулярная готовность — постоянно
- ежемесячные low-blast-radius tests;
- квартальный end-to-end game day;
- повторные evals при каждой смене модели, prompt, tool или policy;
- ежегодный business impact review либо после существенного изменения процесса.
Периодичность является рекомендуемым стартом; критичные организации могут тестировать чаще.
15. Definition of Done
AI-continuity нельзя считать внедрённой, пока не доказано всё перечисленное:
- Критичные AI-зависимые процессы инвентаризированы и имеют владельцев.
- Для каждого процесса определены T-класс, MTPD-AI, RTO-AI и RPO-context.
- Есть task-specific eval set с человеческой ground truth.
- Основная и резервные конфигурации имеют актуальные capability passports.
- Failure domains проверены, а общие зависимости явно записаны.
- Context Capsule создаётся и валидируется автоматически.
- Внешние действия используют policy gateway и idempotency keys.
- Снижение качества автоматически снижает authority.
- Human queue измеряется и имеет capacity/overflow policy.
- Retry budget, circuit breaker и failback hysteresis протестированы.
- Пользователь видит ограниченный режим и судьбу своей работы.
- Game day подтвердил GCR, correct stop и отсутствие дубликатов.
- После учения выполнены корректирующие действия.
16. Короткая памятка руководителю
Задайте команде пять вопросов:
- Если лучшая модель исчезнет сейчас, какие бизнес-действия продолжатся автоматически?
- Какими тестами доказано, что резерв справится именно с этими задачами?
- Где хранится подтверждённый контекст, если чат и провайдер недоступны?
- Кто и с какими доказательствами возьмёт ответственность при снижении качества?
- Когда вы в последний раз реально переключались на резерв и возвращались обратно?
Если хотя бы на один вопрос нет проверяемого ответа, резерв пока является намерением, а не системой непрерывности.
17. Как применять и на что опираться
Сначала прочитайте аналитическую статью. Используйте FMEA для приоритизации отказов, RACI для владельцев и PDCA для цикла учений и улучшений.
Источники
- ISO 22301:2019 (откроется в новой вкладке): управленческая рамка непрерывности; не предписывает шкалы этой методики.
- NIST SP 800-34 Rev. 1 (откроется в новой вкладке): анализ влияния и планирование восстановления.
- NIST AI RMF Core (откроется в новой вкладке): роли, измерения и управление AI-рисками; добровольная рамка.
- Google SRE: Implementing SLOs (откроется в новой вкладке): показатели полезного результата.
- AWS: Avoiding fallback in distributed systems (откроется в новой вкладке): риски резервных путей.
- AWS: Control and limit retry calls (откроется в новой вкладке): ограниченные повторы.
- AWS: Conduct game days regularly (откроется в новой вкладке): проверка восстановления с участием владельцев.
Это методика проектирования, а не внедрённое программное обеспечение, сертификация или юридическое заключение. Для конкретного процесса необходимы собственные тесты, проверка политики данных и утверждение владельца риска.