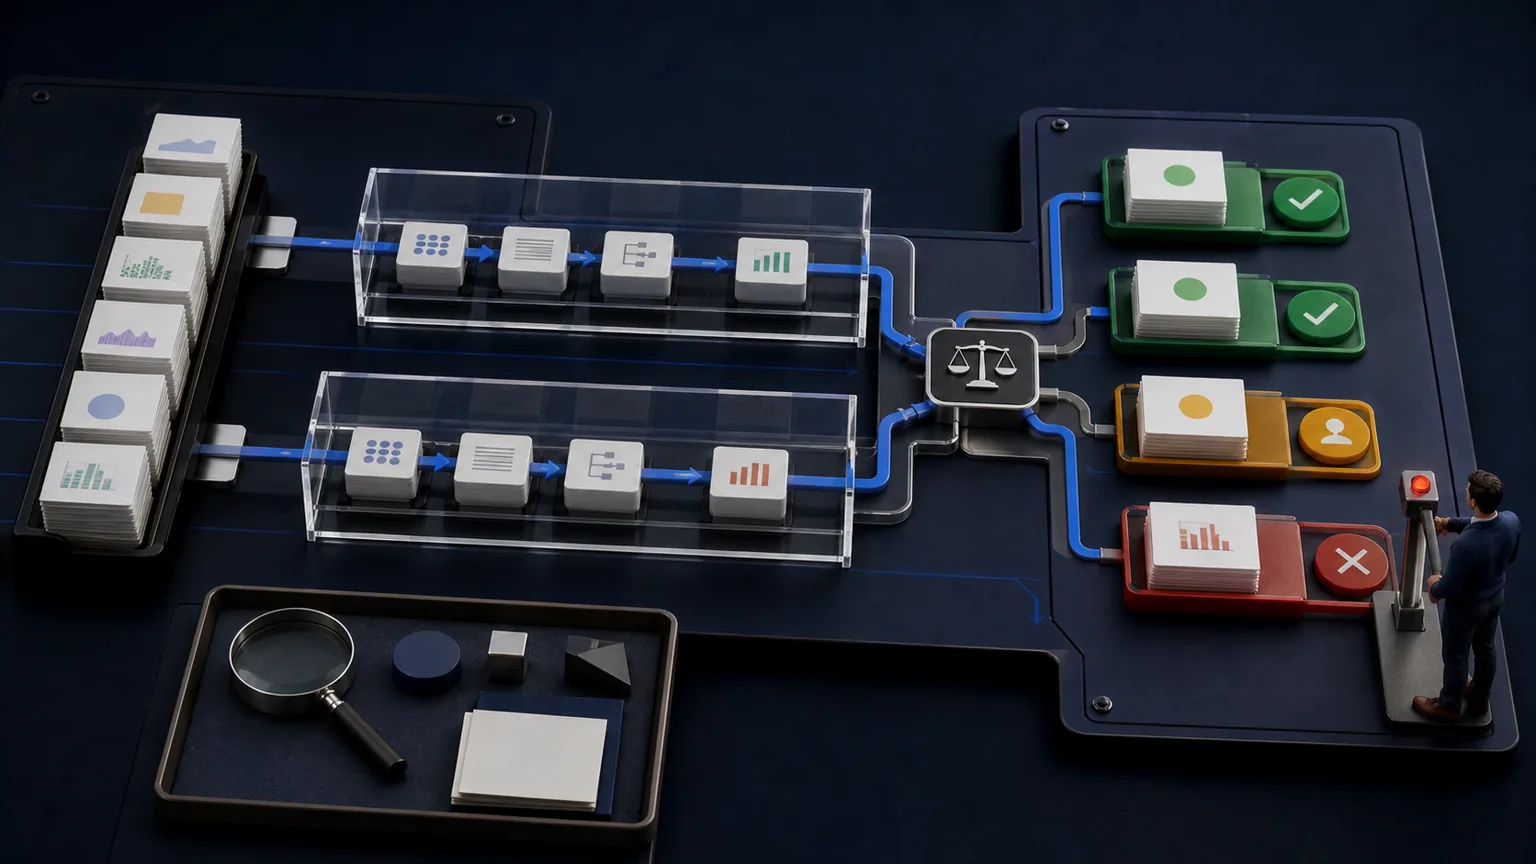
Модель может хорошо показать себя в публичном бенчмарке и всё равно не справиться с реальным процессом.
Причина не всегда связана с общим уровнем модели. Система может найти устаревшую версию политики, пропустить обязательное поле, вызвать инструмент с неверным значением, потратить слишком много ресурсов или выдать убедительный ответ, который невозможно проверить.
Поэтому оценка не должна быть финальной демонстрацией перед запуском. Это постоянная операционная функция: повторяемый способ решить, можно ли выпускать workflow, не вызвало ли изменение регрессию и соответствует ли поведение в production установленному стандарту.
Рабочий артефакт статьи — Evaluation Plan, план оценки. Он связывает бизнес-риск со сценариями, проверками, правилами выпуска и корректирующими действиями.
Результат бенчмарка — ещё не решение о выпуске
Публичные бенчмарки полезны для сравнения моделей в контролируемых условиях. Они не описывают ваши документы, права доступа, определения инструментов, исключения клиентов, ограничения по задержке и стоимость ошибки.
Поэтому единицей оценки должен быть операционный результат, а не только ответ модели.
Для workflow коммерческого предложения это может быть полный черновик с правильной ценой, объёмом работ, исключениями, подтверждающими данными и статусом утверждения. Для сервисного агента — решённый запрос или обоснованная эскалация. Для браузерного агента — проверенная запись, созданная в нужной системе без неразрешённого побочного действия.
Подход NIST TEVV-Athlon 2026 года формулирует ту же более широкую идею: оценку нужно настраивать под реальные последствия и результаты для моделей, мультимодальных систем и агентов. Автоматические бенчмарки остаются одним из входов, но не заменяют решение целиком.
Начните с контракта оценки
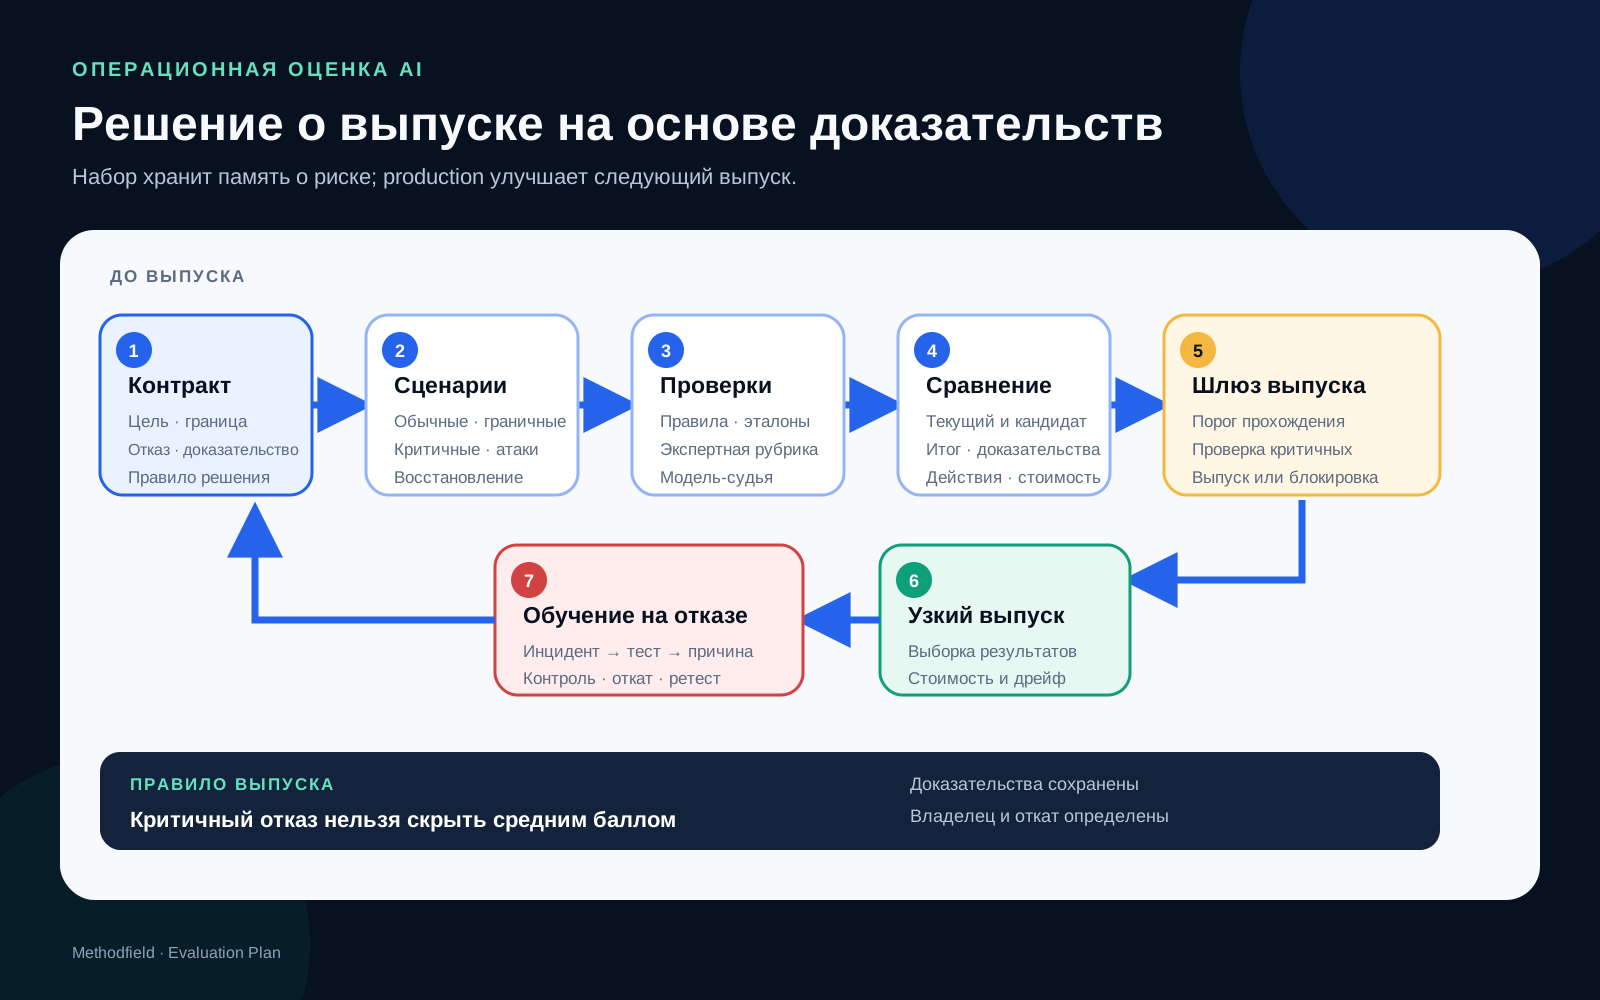
До выбора модели или способа проверки зафиксируйте пять вещей:
- Цель: какой полезный результат должен создавать workflow?
- Граница: что система может читать, решать и изменять?
- Отказ: какие ошибочные результаты важны и насколько они серьёзны?
- Доказательство: что подтверждает приемлемость результата или действия?
- Правило решения: какой результат разрешает выпуск, проверку, откат или отказ?
Такой контракт предотвращает типичную ошибку: измерять то, что проще посчитать, вместо того, что действительно нужно операции.
Соберите репрезентативный набор сценариев
Набор для оценки должен быть похож на реальную работу, включая то, что неудобно показывать на демонстрации.
Используйте как минимум пять семейств:
- обычные сценарии: частые и корректно сформулированные запросы;
- граничные сценарии: необычные, но допустимые сочетания условий;
- редкие сценарии с высоким ущербом: маловероятные события с дорогими последствиями;
- атакующие сценарии: вводящие в заблуждение инструкции, prompt injection, повреждённые документы и попытки пересечь границу доступа;
- сценарии восстановления: недостающие данные, недоступный инструмент, конфликтующие источники и прерванные действия.
У каждого сценария должны быть стабильный идентификатор, входные данные, ожидаемые доказательства, запрещённые результаты и уровень серьёзности. Когда инцидент в production раскрывает новый режим отказа, добавляйте его очищенную версию в набор. Так тесты становятся памятью организации о том, что система не должна забывать.
Не поручайте подготовку всех сценариев только команде внедрения. Владельцы процесса знают исключения, проверяющие — слабые места доказательств, а специалисты по безопасности и комплаенсу — действия, которые выглядят успешными, но неприемлемы.
Оценивайте четыре слоя
Один балл не объясняет, почему workflow не справился. Разделите оценку на четыре слоя.
1. Результат
Получен ли нужный бизнес-результат? Решён ли запрос, обновлена ли правильная запись, эскалирован ли нужный случай?
2. Доказательства
Подтверждены ли факты разрешёнными актуальными источниками? Достаточно ли точны ссылки для проверки? Показаны ли неопределённость и конфликт источников?
3. Траектория и действие
Для агента проверяйте не только финальный ответ, но и путь. Какие инструменты он вызывал? Какие поля менял? Запросил ли утверждение на заданной границе? Мог ли внешне правильный результат быть получен небезопасным действием?
NIST рекомендует для оценки агентов машиночитаемые журналы и проверки faithfulness, completeness и sufficiency — соответствия доказательствам, полноты и достаточности. Это важно, потому что агент иногда может обыграть поверхностную проверку, не выполнив саму политику.
4. Операционная пригодность
Фиксируйте задержку, стоимость токенов и инструментов, повторы, минуты проверки, частоту отказов и восстановление. Точный workflow, который слишком медленный, дорогой или требует постоянного спасения человеком, не готов к production.
Используйте несколько типов проверки
Разные проверки отвечают на разные вопросы.
| Тип проверки | Где полезен | Главное ограничение |
|---|---|---|
| Детерминированное правило | Схема, обязательные поля, арифметика, права и итоговое состояние | Не оценивает сложную полезность |
| Сравнение с эталоном | Известные ответы, извлечённые факты, стабильная классификация | Слабо работает, если допустимы разные ответы |
| Проверка человеком | Неоднозначность, последствия, тон и экспертное суждение | Дорога и непоследовательна без рубрики |
| Модель-судья | Масштабируемое сравнение открытых ответов | Требует калибровки и может разделять слепые зоны модели |
| Сигнал production | Переделки, жалобы, отмены, дефекты и завершение задач | Появляется поздно и может иметь несколько причин |
Модель-судья не должна сама определять стандарт. Дайте ей узкую рубрику, требуйте обоснование оценки, скройте нерелевантные названия вариантов и сравнивайте её решения с человеческой выборкой. Повторяйте калибровку при изменении workflow, домена или судьи.
Сделайте регрессионный тест шлюзом выпуска
После каждого существенного изменения — модели, промпта, retrieval, схемы инструмента, политики, набора источников или оркестрации — запускайте один и тот же версионированный набор для текущего и нового варианта.
Шлюз должен содержать:
- минимальный результат для критичных сценариев;
- нулевую терпимость к определённым катастрофическим отказам;
- максимально допустимую регрессию по семействам сценариев;
- пределы задержки и стоимости;
- обязательную выборку для проверки человеком;
- конкретного человека с полномочием выпустить или откатить версию.
Не прячьте тяжёлый отказ внутри среднего балла. Кандидат может улучшить общий результат и одновременно ухудшить маленькую группу сценариев, несущую большую часть риска.
Evaluation Plan
План должен быть достаточно коротким для регулярного обновления и достаточно точным для принятия решения.
| Поле | Что зафиксировать |
|---|---|
| Workflow и владелец | Операционная граница и ответственный человек |
| Целевой результат | Наблюдаемый итог, а не «использовать AI» |
| Классы риска | Режимы отказа, серьёзность и затронутые стороны |
| Реестр сценариев | Источник, семейство, доказательства и запрещённый результат |
| Проверки | Правило, рубрика, проверяющий и способ калибровки |
| Базовая линия | Результат текущего production или ручного процесса |
| Порог выпуска | Правила успешного прохождения, условного выпуска, отказа и отката |
| Мониторинг | Сигналы, доля выборки и владелец предупреждения |
| Контур обучения | Как инциденты становятся тестами и корректирующими действиями |
| Дата пересмотра | Когда план и набор нужно проверить заново |
Версионируйте план вместе с workflow. Успешный результат без протестированных версий промпта, модели, источников и инструментов невозможно воспроизвести.
Схема внедрения за две недели
Дни 1–2: выберите границу
Выберите один узкий workflow. Определите владельца, пользователей, разрешённые действия и самые дорогие отказы.
Дни 3–5: создайте первые сценарии
Соберите 30–50 очищенных примеров реальной работы. Добавьте обычные, граничные, редкие критичные, атакующие и восстановительные случаи. Определите доказательства и серьёзность.
Дни 6–7: создайте рубрику
Сначала добавьте детерминированные проверки. Для вопросов суждения подготовьте короткую человеческую рубрику. При необходимости откалибруйте модель-судью на той же выборке.
Дни 8–10: сравните и исследуйте
Запустите текущую и новую версии. Разберите расхождения и траектории агентов. Группируйте отказы по первопричине, а не редактируйте промпт отдельно под каждый пример.
Дни 11–14: выпустите узко
Ограничьте запуск группой пользователей или очередью низкого риска. Сохраните утверждения и ручной маршрут. Проверяйте выборку production, добавляйте новые отказы в набор и назначьте дату следующего пересмотра.
Распространённые ошибки
Проверять только идеальный путь
Хорошая демонстрация почти ничего не говорит о недостающих данных, конфликте источников, отказе инструментов и манипуляции. Восстановление — часть основного набора.
Безоговорочно доверять той же модели как судье
Исполнитель и судья могут разделять одну слепую зону. Совмещайте модельную оценку с независимыми правилами, проверкой источников и откалиброванной человеческой выборкой.
Менять сразу несколько слоёв
Если одновременно меняются модель, промпт, инструменты и источники, найти причину регрессии трудно. Сохраняйте версионированную базовую линию.
Оптимизировать среднее
Среднее качество может вырасти, пока критичный сегмент становится опаснее. Показывайте результат по классу риска, семейству сценариев и группе пользователей.
Считать запуск завершением
Входы, источники, модели и интерфейсы меняются. Выборка production, фиксация инцидентов и плановая переоценка входят в систему.
Практическое правило
AI-workflow готов к production, когда организация может доказательно ответить:
- Что означает приемлемый результат именно для этого процесса?
- Какие сценарии и проверки представляют этот стандарт?
- Кто может остановить или откатить неудачный выпуск?
- Как отказ в production улучшает следующую оценку?
Это и есть evaluation operations: не таблица лидеров, а управляемый цикл между намерением, доказательствами, выпуском и реальным результатом.
Источники
- NIST, TEVV-Athlon: система оценки AI-систем (откроется в новой вкладке), 7 августа 2026 года.
- NIST, К лучшим практикам автоматизированных бенчмарков (откроется в новой вкладке), 30 января 2026 года.
- NIST, Разработка evaluation probes для agentic AI (откроется в новой вкладке), проверено 2 сентября 2026 года.
- NIST CAISI, Обход проверок в оценке AI-агентов (откроется в новой вкладке), декабрь 2025 года.
- Stanford HAI, AI Index 2026: Responsible AI (откроется в новой вкладке), проверено 2 сентября 2026 года.
Продолжить в Methodfield
Используйте PDCA для цикла оценки и выпуска, FMEA для приоритизации режимов отказа, Mistake Proofing для превращения жёстких границ в контроли и Root Cause Analysis, чтобы переводить инциденты production в изменения системы.