Контекстное окно — максимальный объём информации, доступный модели в одном запросе или ходе. Это ограничение вместимости, а не гарантия, что модель одинаково хорошо использует каждую строку. С ростом окна возникает удобная архитектурная привычка: положить в запрос весь договор, переписку, базу знаний и журнал действий. Система начинает выглядеть «осведомлённой», а счёт и риск ошибки растут.
Исследование Lost in the Middle (откроется в новой вкладке) показало на исследованных задачах поиска и ответов по нескольким документам, что позиция нужной информации в длинном контексте влияет на качество: материал в середине мог использоваться хуже. Работа RULER (откроется в новой вкладке) предлагает более разнообразную проверку длинного контекста, чем извлечение одной искусственно спрятанной строки. Вывод для бизнеса аккуратен: рекламируемый размер окна следует отличать от надёжно используемого объёма на вашей задаче. Эти работы не доказывают, что все новые модели одинаково испытывают проблему.
Скрытая цена повторения истории
Если система на каждом из десяти ходов повторно отправляет 20 тысяч токенов истории, получается 200 тысяч появлений входных токенов ещё до новых сообщений и ответов. По тарифу $2 за миллион входных токенов это $0.40 при отсутствии кэширования. Это иллюстрация, а не счёт конкретного продукта. Кэш или управление состоянием могут заметно изменить результат, но кэш требует совпадающих пригодных префиксов и имеет правила конкретного провайдера. OpenAI описывает эти условия отдельно (откроется в новой вкладке).
Длинный контекст может изменить сам тариф. У Gemini 3.1 Pro Preview после порога 200 тысяч токенов промпта ставка входа по официальной таблице поднимается с $2 до $4, а выхода — с $12 до $18 за миллион. Поэтому добавление «ещё одного документа» около порога может стоить больше, чем предполагает простой линейный расчёт. Google API pricing (откроется в новой вкладке).
Четыре способа дать модели материал
Полная загрузка уместна, когда документ небольшой, все детали действительно важны, а число обращений невелико. Плюс — простота; минус — шум и повторная оплата.
Поиск и извлечение (RAG) выбирают релевантные фрагменты по вопросу. Это сокращает вход, но вводит другой риск: нужный фрагмент может не попасть в выборку. Качество поиска нужно измерять отдельно от качества ответа.
Краткая память или сжатие сохраняет решения и факты предыдущих шагов. Это экономит токены, но плохое резюме может потерять исключение или контекст согласования. Для критичных процессов храните ссылку на оригинал.
Кэширование стабильного префикса выгодно, когда много запросов повторяют одни инструкции, схемы и документы. Считайте фактическую долю попаданий, стоимость записи и срок жизни кэша, а не рекламный процент скидки.
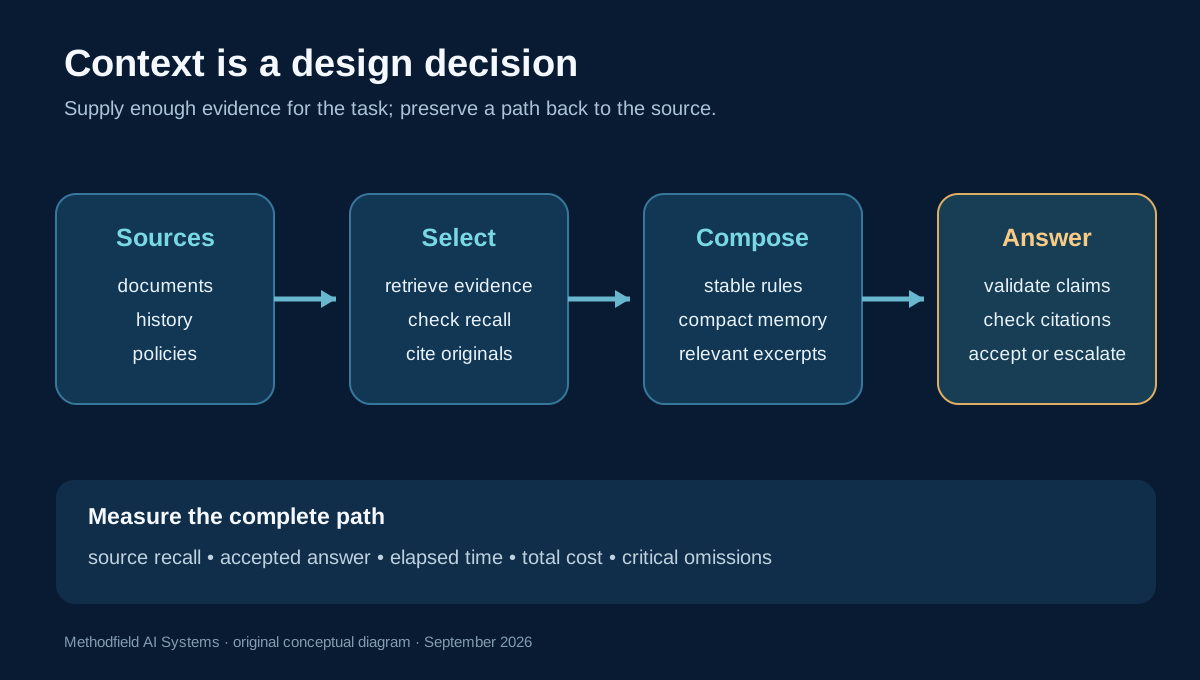
Чаще всего работает комбинация: короткие стабильные правила + поиск по первоисточникам + проверяемые цитаты + ограниченная память решений. Перед ответом можно попросить систему указать, какие документы ей понадобились. Но ссылка, созданная самой моделью, не равна доказательству: проверяйте, что она ведёт к реальному фрагменту.
Эксперимент, который стоит провести
Соберите 100–200 типичных и сложных запросов. Для каждого зафиксируйте правильный ответ и обязательный источник. Сравните полную загрузку, RAG и гибрид на одинаковой модели: полнота найденных источников, точность ответа, цитирование, задержка, входные и выходные токены, стоимость исправления. Добавьте тесты, где ключевой факт находится в начале, середине и конце большого документа. Если гибрид экономит 60% токенов, но теряет 15% обязательных фактов, экономия может быть мнимой.
Контекст — это цепочка отбора, а не корзина документов
Перед моделью обычно стоят несколько решений. Какие документы вообще имеют право участвовать в ответе? Какая версия политики действовала на дату вопроса? Какие фрагменты относятся к конкретному клиенту? Как убрать дубликаты, не потеряв исключение? Как разместить найденное так, чтобы модель могла отличить инструкцию от цитаты? Даже идеальная генерация не исправит неверный выбор источника. Поэтому у длинного контекста есть качество входа, которое нужно проектировать отдельно.
В RAG-процессе минимум три ошибки различны. Первая — поиск не нашёл нужный документ. Вторая — нашёл, но выбрал нерелевантный или устаревший фрагмент. Третья — модель получила правильный фрагмент, но сделала неподтверждённый вывод. Если измерять только «понравился ли финальный ответ», источник сбоя остаётся невидимым. Работы RAGAS (откроется в новой вкладке) и ARES (откроется в новой вкладке) предлагают оценивать релевантность контекста, верность ответа источнику и полезность результата раздельно. Автоматическая оценка ускоряет итерации, но её стоит сверять с размеченными экспертами случаями.
Практика отбора: от запроса к доказательствам
Для базы знаний компании сначала разделите документы по полномочию и времени действия: утверждённая политика, рабочая инструкция, архивное обсуждение и пользовательский комментарий не должны выглядеть одинаково. Затем определите единицу поиска. Слишком маленький фрагмент теряет смысл условия; слишком большой приносит шум и повторный счёт. Для каждого найденного фрагмента сохраняйте источник, версию, дату и доступ. Если ответ требует нескольких документов, проверьте, что система извлекла именно их сочетание, а не один удобный текст.
Компрессия полезна, если удаляет повтор и декоративную информацию, сохраняя факты, исключения и происхождение. Опасная компрессия превращает «возврат возможен при трёх условиях» в «возврат возможен». Для задач с последствиями краткое резюме должно сопровождаться ссылкой на первоисточник, а решение — фиксировать, какая версия правила была применена.
Где кэш действительно помогает
Кэширование не является способом «запомнить всё». Оно экономит повторную обработку одинакового пригодного префикса. Если в начало промпта вставлять уникальный идентификатор, текущую дату или случайный порядок инструментов, совпадение может разрушиться. Стабильные правила и схемы лучше размещать отдельно от переменной части запроса. Но ради кэш-попадания нельзя смешивать данные разных клиентов или оставлять устаревшую политику. Для бизнеса стоимость промаха кэша иногда ниже стоимости неправильного ответа.
Оценка кэша должна учитывать частоту повторного использования, размер стабильной части, тариф записи и чтения, срок хранения и вероятность обновления материала. Это особенно важно для агентов: каждый новый шаг может снова передавать историю, но не вся история должна оставаться в активном контексте. Журнал действий храните в системе наблюдаемости; модели передавайте проверенный краткий статус и необходимое доказательство для следующего шага.
Когда полный контекст разумнее поиска
RAG — не обязательный ответ на любой длинный документ. Если договор один, объём умеренный и вопрос требует прочитать все пункты, полная загрузка может быть проще и надёжнее. Если база документов большая, часто обновляется и каждый вопрос затрагивает небольшую долю, поиск обычно выигрывает в управляемости. Если решение требует всей истории обсуждения, могут понадобиться и компактная память, и выбранные первоисточники. Критерий выбора — не длина промпта сама по себе, а полнота доказательств, проверяемость ответа и полная стоимость.
Сквозной пример: что положить в контекст агенту магазина
Письмо клиента: «Где заказ и можно ли поменять адрес?» Полная загрузка всей базы знаний магазина добавит инструкции по гарантиям, возвратам и рекламным акциям, которые не относятся к вопросу. Но слишком узкий поиск по слову «адрес» может пропустить правило, что после передачи заказа перевозчику изменение возможно только через отдельное согласование. Для ответа нужны три вида контекста: актуальный статус конкретного заказа, действующая политика изменения адреса и история уже данных клиенту обещаний. У каждого вида свой источник и право доступа.
Сначала система определяет идентификатор заказа и авторизацию клиента. Затем запрашивает статус через инструмент, а не пытается угадать его из переписки. После этого извлекает версию политики, действующую сейчас; если вопрос касается действия, выясняет и момент, когда заказ перешёл к перевозчику. Наконец, сверяет, не обещал ли сотрудник ранее то, что конфликтует с правилом. В промпт попадают только необходимые факты, но рядом сохраняются ссылки на оригиналы и время их получения.
Если политика и статус противоречат друг другу, система не должна «примирять» их гладким ответом. Она фиксирует конфликт и передаёт случай человеку. Это пример, когда меньший контекст может улучшить надёжность: модель видит компактное, явно маркированное противоречие вместо длинной истории, где важное условие теряется. Однако сокращение допустимо лишь после качественного поиска и проверки полноты источников.
Что измерять в таком дизайне
Проверка контекста начинается до генерации. Для каждого тестового обращения эксперт отмечает обязательные факты: нужный статус, правило, исключение и право на действие. Система поиска получает оценку за то, что действительно принесла эти факты. Генератор оценивается отдельно: не добавил ли неподтверждённого обещания, точно ли выразил правило, корректно ли признал недостаток данных. Если ответ принят, но источник неверный, случай всё равно должен считаться дефектом — иначе будущий аудит окажется невозможным.
Набор тестов должен содержать несколько версий одного правила, документы с похожими названиями, конфликтующие сообщения клиента, длинную историю и запросы на двух языках. При обновлении политики запускается не только тест нового документа, но и регрессия старых типовых сценариев. Это особенно важно для кэша и краткой памяти: обе техники повышают риск того, что агент будет держаться за вчерашний факт.
Есть и вопрос приватности. Большое окно технически позволяет смешать много данных, но право пользователя видеть их от этого не расширяется. Поиск должен фильтровать документы по доступу до передачи модели. Кэширование стабильных инструкций можно применять широко; кэширование клиентских сведений требует отдельного учёта арендатора, срока жизни и правил поставщика. Экономия на входных токенах не оправдывает утечку соседнего заказа.
Таким образом, контекст — это не просто текстовый лимит. Это управляемый набор доказательств со временем действия, происхождением и границей доступа. Чем яснее эта структура, тем проще менять модель, проверять ответ и считать затраты.
Два бюджета контекста: вместимость и внимание
У окна есть технический предел, но при проектировании полезно ввести и более строгий бюджет внимания: сколько материала модель действительно должна сопоставить для конкретного решения. Длинный текст не обязательно плох; плохо, когда в нём нет иерархии. Системные правила, проверенные факты, цитаты, история диалога и результаты инструментов должны быть различимы по происхождению и роли. Иначе модель может принять фрагмент письма клиента за инструкцию или недействующее правило — за текущую политику.
Практическая упаковка контекста начинается с вопроса и критерия ответа. Затем идут обязательные правила, краткое состояние случая и выбранные доказательства. Большие результаты инструментов лучше фильтровать до нужных полей; длинный журнал действий — сжимать в проверенное состояние, сохраняя полный лог отдельно. Это не «секретный порядок промпта», а способ сделать каждую часть проверяемой. Если ответ ошибочен, команда сможет сказать, был ли факт не найден, потерян при сжатии или неверно истолкован.
Для мультимодального входа осторожность ещё важнее. Страница PDF, изображение счета или аудиозапись не равны «стольким-то словам текста» с точки зрения тарификации и ошибок распознавания. Сначала проверьте качество извлечения: OCR мог пропустить сумму, таблица — потерять связь столбцов, аудио — неверно передать имя. Смена языковой модели не исправит отсутствие исходного факта. В оценке держите отдельные случаи для ошибки восприятия и ошибки рассуждения.
Практическое решение: загрузить всё или искать?
Задайте пять вопросов. Нужны ли для ответа почти все части документа? Как часто материал меняется? Сколько вопросов будет задано к одному и тому же источнику? Насколько опасно пропустить один фрагмент? Можно ли проверить цитаты автоматически? Если документ один и целиком важен, полная загрузка может быть оправданной. Если вопросов много и каждый касается узкой части большого корпуса, поиск с проверкой полноты обычно масштабируется лучше. Если пропуск критичен, используйте гибрид: сначала извлеките кандидатов, затем расширьте чтение вокруг найденных мест или передайте случай человеку.
Не оптимизируйте контекст в отрыве от качества. Короткий промпт с плохими источниками дешёв только до первой ошибки. Длинный промпт, в котором ключевой факт невозможно найти, дорог и ненадёжен. Цель — минимальный достаточный доказательный пакет. Его достаточность устанавливается на тестах с известными ответами и при изменениях базы знаний пересматривается.
Вывод: большое окно расширяет возможную архитектуру. Эффективный контекст — тот, который содержит достаточно проверяемой информации для правильного решения и не заставляет платить за неиспользуемый шум.
Далее: Как выбрать модель под задачу.