«Какая модель самая выгодная?» — вопрос без одного ответа. Для извлечения полей из типового документа и для проверки сложного спорного решения нужны разные свойства. Публичный тариф полезен в конце выбора, когда уже понятно, какую работу модель должна выполнить и что произойдёт, если она ошибётся. Для закупочного сравнения проверяйте актуальные тарифы OpenAI (откроется в новой вкладке), Anthropic (откроется в новой вкладке), Google (откроется в новой вкладке) и Mistral (откроется в новой вкладке). Статью можно применять и после следующего изменения тарифов.
Сначала опишите тип работы
Отделите закрытую задачу с проверяемым ответом (классификация, извлечение полей) от открытой (анализ аргументов, проектирование, сложный черновик). Затем укажите: какие источники нужны, сколько шагов требуется, может ли модель вызывать инструменты, допустима ли неопределённость, кто принимает решение и каков ущерб от ошибки. Для агента добавьте право действовать: чтение, предложение, обратимое действие или изменение внешней системы. Это сильнее влияет на выбор, чем позиция модели в общем рейтинге.
| Тип задачи | Стартовый кандидат | Что проверять особенно тщательно |
|---|---|---|
| Массовая классификация и извлечение | малый быстрый класс | редкие форматы, языки, пропуски, корректный отказ |
| Подготовка черновика с документами | сбалансированный класс | источники, полнота, длина ответа, число правок |
| Сложное исследование или разработка | сильный класс | рассуждение по длинной цепочке, воспроизводимость, время |
| Агент с инструментами | класс, который надёжно выбирает и вызывает инструменты | правильные аргументы вызова, предел шагов, остановка и откат |
Это гипотезы для теста. У конкретного поставщика «малый» может обгонять «сильный» на узкой задаче, а дорогой модельный вызов может снизить общую цену за счёт меньшего числа повторов.
Где искать практическую выгоду
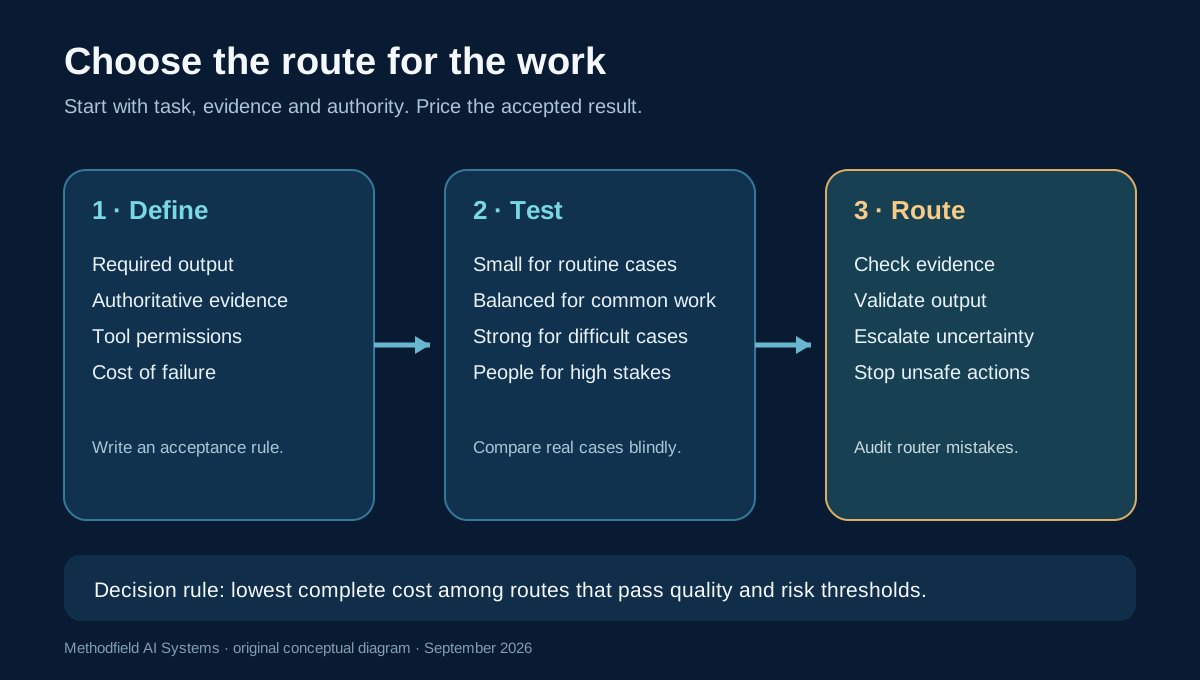
Для массовой классификации, маршрутизации, простого извлечения и кратких черновиков начните с дешёвого класса: GPT-6 Luna, Gemini Flash-Lite, Mistral Small. Это кандидаты для теста, а не утверждение, что они одинаково качественны. Отберите реальные случаи с разными форматами, языками и исключениями. Если малый класс не проходит порог, рассмотрите следующую ступень.
Для сложных документов, многошаговых задач и инструментов проверьте сбалансированные модели: GPT-6 Sol, Claude Sonnet 5, Gemini 3.8 Flash, Mistral Medium 3.5. Разница в тарифе может окупиться, если модель реже ошибается, меньше повторяет вызовы и лучше соблюдает формат.
Для дорогих ошибок, сложной разработки и исследований проверьте флагманские модели и отдельный человеческий контроль. «Дороже за токен» не означает «лучше для каждого запроса»; оно может означать меньше исправлений в одном узком, трудном классе. Уточняйте условия доступа к preview-моделям и сроки промо-тарифов.
Соберите маршрут, а не назначайте одну модель на всё
Практическая конфигурация может состоять из маленькой модели для распознавания типа запроса, специализированного инструмента для поиска фактов, сбалансированной модели для стандартного ответа и сильной модели для редкого сложного случая. Эскалацию запускают признаки: недостаток источников, конфликт данных, низкая уверенность валидатора, большая сумма или запрос на действие с последствиями. Но отдельный маршрутизатор тоже ошибается; его качество проверяют на сложных примерах, а цену включают в общую смету.
Как сравнить честно
Сформируйте одинаковый набор случаев, но не заставляйте разные API имитировать чужие возможности. Дайте каждой модели согласованную инструкцию и одинаковые источники; зафиксируйте температуру, усилие рассуждения, инструменты, дату версии. Считайте фактические токены из ответов API, стоимость всех попыток, время до приемки и работу человека. Для опасных ошибок задайте предельную частоту отдельно.
Именно поэтому ценовая таблица в приложении не рейтинг моделей. Её назначение — показать, насколько ставка меняет нижнюю границу счета и где начинаются вопросы качества. Исследование HELM (откроется в новой вкладке) напоминает, что оценка модели требует нескольких сценариев и метрик, а не одного общего балла.
AI Index 2026 (откроется в новой вкладке) также отмечает сближение сильных моделей на части публичных рейтингов и проблемы надёжности отдельных бенчмарков. Это усиливает смысл локальной проверки: небольшое отличие общего балла не сообщает, кто лучше обрабатывает ваши документы, инструменты и исключения.
Шесть требований, которые меняют короткий список моделей
Качество на типовом случае. Достаточно ли модель выполняет основную работу, или красивый ответ скрывает пропущенное поле? Измеряйте по рубрике, а не по общему впечатлению. Для извлечения оценивайте поля и допустимые пропуски; для письма — корректность обязательных фактов и готовность сотрудника принять черновик.
Качество на границе. Что происходит при плохом скане, противоречивых документах, редком языке, неполной политике или неизвестном формате? Здесь часто выясняется, какая модель требует меньше дорогих исключений. Проведите отдельный тест на случаи, где правильный ответ — «не знаю» или «нужно согласование».
Инструменты и структурированный вывод. Агенту недостаточно написать связный текст. Он должен правильно выбрать инструмент, передать схему аргументов, интерпретировать ошибку, избежать лишнего вызова и не продолжать действие после запрета. Сравнивать модели для агента только по вопросам и ответам — значит не тестировать центральную часть работы. Исторический AgentBench (откроется в новой вкладке) как раз развёл агентные действия по интерактивным средам; его старые баллы не следует превращать в рейтинг нынешних моделей.
Ограничения данных. Проверьте регион обработки, правила хранения, доступные журналы и договорные требования к данным. Самый дешёвый тариф может быть недоступен для нужного региона или режима. Это ограничение выбора, а не «надбавка, о которой вспомним после пилота».
Время и предсказуемость. Для массовой фоновой обработки подходит один режим, для оператора, ожидающего ответ в разговоре, — другой. Средняя скорость мало говорит о длинном хвосте; смотрите задержку принятого результата и лимиты запросов в периоды нагрузки.
Стабильность и переносимость. Версия модели, её обновление и изменение токенизатора могут сдвинуть качество и счёт. Храните небольшой контрольный набор и возможность переключить маршрут. Не привязывайте бизнес-правило к случайной формулировке ответа модели.
Маршрутизация как управляемая политика
Маршрутизатору не обязательно быть отдельной большой моделью. Начните с явных правил: тип документа, язык, размер, наличие источника, право действия. Лишь если правила не покрывают поток, тестируйте модельный классификатор. Сложность запроса нельзя измерить одним словом «сложный»: для счёта это может быть нетипичный поставщик; для договора — конфликт условий; для агента — действие без обратимого пути. Эскалация должна объяснять, почему выбрана другая модель или человек.
Исследования FrugalGPT (откроется в новой вкладке) и RouteLLM (откроется в новой вкладке) показывают потенциал каскада и маршрутизации на изученных наборах задач. Но экономия зависит от способности верно отделять лёгкие запросы от трудных. Ошибка «сложный случай отправлен дешёвому маршруту» может быть дороже ошибки «простой случай отправлен сильному». Поэтому оценивайте маршрутизатор по пропускам опасных случаев, а не только по средней доле вызовов дорогой модели.
Пример: агент по обработке входящих заказов
Разложим работу на операции. Определить тип письма можно проверить по размеченной истории. Найти актуальную политику доставки — по источнику и версии. Подготовить ответ — по обязательным фактам и редакторской приемке. Обновить заказ — уже действие с последствиями; ему нужны разрешение, ограничения и журнал. Первая операция может использовать небольшой класс, средние — модель с устойчивой работой с источниками, последняя — проверенный инструмент и контроль полномочий. Сильнейшая модель на всех этапах могла бы увеличить счёт без роста результата; одна дешёвая на всех этапах могла бы увеличить риск.
Для каждой операции установите собственный порог качества. Если проверка после модели дорога, ставка на более сильную модель может быть экономной. Если действие строго детерминированное, не заставляйте модель «решать» правило, которое можно выразить кодом. Она может распознать ситуацию и подготовить объяснение, а само условие выполнит обычная программа.
Как провести сравнение так, чтобы ему можно было доверять
Сначала сформируйте выборку до настройки маршрута. Пусть в ней будут частые простые случаи, редкие спорные, старые документы, новые форматы, двуязычные обращения и запросы на запрещённое действие. Отдельно оставьте контрольный набор, который не показывают команде при настройке промптов. Иначе конфигурация постепенно подстроится под известные примеры, а оценка станет слишком оптимистичной.
Каждому кандидату дайте одинаковое описание задачи, одни и те же источники и критерии приемки, но используйте родной формат его API для инструментов и структурированного вывода. Сравнивать модель, которой доступны инструменты, с моделью, которой дали только текстовое описание инструмента, нечестно. Фиксируйте версию модели, режим рассуждения, лимиты длины, дату теста и фактически выставленные токены. Повторяйте наиболее важные случаи, потому что один удачный ответ не доказывает устойчивость.
Оценка должна состоять из нескольких «ворот». Первые — жёсткие: не раскрывать чужие данные, не выполнять действие без права, не выдумывать статус заказа. Вторые — качество: полнота, точность, источники, понятность клиенту. Третьи — эксплуатация: время, стоимость принятого результата, доля эскалаций, предсказуемость лимитов. Конфигурация, не прошедшая первые ворота, не выигрывает из-за низкого тарифа. Так решается проблема, когда взвешенный общий балл позволяет хорошей скорости «компенсировать» опасную ошибку.
Три стратегии размещения моделей
Один поставщик и несколько классов моделей упрощают интеграцию и единый учёт, но создают зависимость от его тарифов, лимитов и продуктовых решений. Несколько поставщиков дают резерв и шанс использовать сильные стороны каждого, но усложняют авторизацию, подсчёт токенов, наблюдаемость и юридическую проверку. Самостоятельный хостинг открытой модели даёт контроль над средой и может быть выгоден при стабильном большом объёме, но требует инженерной команды, оборудования, обновлений, мониторинга и измерения качества. Нельзя сравнивать его только с ценой токена API, забыв загрузку серверов и дежурство.
Выбор зависит от формы нагрузки. Редкие непредсказуемые запросы обычно легче оплачивать по использованию. Ровный большой поток можно оценивать на собственном оборудовании или контрактном объёме. Но владение вычислением само по себе не создаёт качество: та же локальная проверка на реальных случаях остаётся обязательной. Для критичного процесса полезен план деградации: что делает система, когда предпочтительная модель недоступна или превысила бюджет? Она может перейти на другую модель для низкого риска либо остановить автоматическое действие.
Что пересматривать после запуска
Раз в заданный период смотрите не только на цены, но и на состав задач. Появились новые языки, канал общения, тип договора, более длинная история? Это меняет сложность потока. Снижение цены одной модели может оправдать новый эксперимент; улучшение её публичного рейтинга — только повод проверить, улучшает ли она вашу метрику. Решение о миграции должно включать стоимость переноса промптов, инструментов, тестов и возможных ошибок переходного периода.
Экономичная модельная политика — документируемая и обратимая. Команда должна знать, по какому правилу случай попал на конкретный маршрут, как изменить правило и как обнаружить, что маршрутизатор перестал распознавать исключения.
Матрица выбора без искусственного «общего победителя»
После теста составьте не рейтинг из одного столбца, а короткую карточку по каждой операции: обязательные условия, уровень качества, тип ошибки, затраты на принятый результат, задержка, инструменты, ограничения данных и резервный маршрут. Если кандидат не проходит обязательное условие, не давайте ему высокий суммарный балл за скорость или цену. Между оставшимися вариантами сравнивайте именно те различия, которые влияют на работу. Для сортировки писем это может быть пропуск редкой категории; для договора — неверная ссылка на пункт; для агента — лишнее действие.
Проводите парное сравнение не только моделей, но и архитектур. Один и тот же сильный модельный класс может работать плохо, если ему дали устаревший документ. Более слабый класс с качественным поиском и валидатором может дать лучший принятый результат. Сравните «модель A + полный контекст», «модель A + поиск», «модель B + поиск» и «маршрут A→B при неопределённости». Изменяйте по одному крупному компоненту за раз, чтобы понимать причину эффекта.
Для агентной задачи добавьте тест на поведение после ошибки. Инструмент возвращает тайм-аут, противоречивый статус или частичный результат. Продолжит ли агент безопасно? Проверит ли, выполнено ли действие, прежде чем повторить его? Попросит ли человека о решении, когда политика не покрывает случай? Эти вопросы редко отражаются в общей цене модели, но определяют её пригодность к эксплуатации.
В конце назначьте модель не «компании», а маршруту задачи. Сегодня малый класс может обслуживать обычные вопросы о доставке, сбалансированный — готовить ответы по документам, сильный — разбирать спорные исключения, а детерминированный код — принимать решение о допустимости изменения заказа. Через несколько месяцев распределение может измениться. Хорошая архитектура позволяет пересмотреть роли без переписывания всего процесса.
Вывод: сначала определите приемлемое качество на своей задаче, затем выбирайте самый дешёвый маршрут, который устойчиво проходит этот порог.
Далее: Что такое эффективность ИИ.
Источники
- OpenAI (откроется в новой вкладке)
- Anthropic (откроется в новой вкладке)
- Google (откроется в новой вкладке)
- Mistral (откроется в новой вкладке)
- HELM (откроется в новой вкладке)
- AI Index 2026 (откроется в новой вкладке)
- AgentBench (откроется в новой вкладке)
- FrugalGPT (откроется в новой вкладке)
- RouteLLM (откроется в новой вкладке)