Слово «эффективность» часто используют в несовместимых смыслах. Инженер может иметь в виду токены в секунду. Финансовый директор — стоимость запроса. Руководитель сервиса — число обращений, закрытых без повторного контакта. Сотрудник — сколько времени экономит система, если затем надо проверить каждую строку. Все четыре измерения полезны, но ни одно не описывает результат целиком.
Для рабочего процесса эффективность можно определить так: доля принятых результатов, полученных в срок при допустимом риске, на единицу полного ресурса. Это не универсальная физическая константа, а операционное определение. Оно требует сначала назвать, что именно считается принятым результатом.
Пять измерений
- Качество: точность обязательных полей, полнота, соблюдение правил, обоснованность ответа и доля случаев, где система честно сообщает о неопределённости.
- Скорость: время до первого ответа и, важнее, до принятого результата; отдельно 50-й и 95-й процентили.
- Стоимость: модель, данные, инструменты, повторные вызовы, инфраструктура, проверка человеком и исправление ошибок.
- Риск: тяжёлые ошибки, нарушения доступа, неподтверждённые действия, невозможность восстановить ход решения.
- Нагрузка на команду: время проверки, когнитивное переключение, количество исключений и поддержка системы после запуска.
HELM (откроется в новой вкладке) был создан именно потому, что единая метрика точности скрывает устойчивость, калибровку и другие свойства моделей. Для агентной работы METR (откроется в новой вкладке) изучает, какой длительности задачи система выполняет успешно; такие результаты зависят от постановки, инструментов и критериев. Нельзя напрямую перенести число из публичного бенчмарка в обещание для вашего процесса.
В AI Index 2026 (откроется в новой вкладке) Stanford HAI показывает, что измеримые выигрыши лучше заметны в структурированной работе, где результат можно контролировать; внедрение агентов в бизнес-функциях пока существенно менее зрелое, чем общее использование ИИ. Это аргумент начинать с измеримого потока и постепенно расширять полномочия, а не строить финансовую модель на демонстрации агента.
Пример неверного выбора
Малая модель может стоить в несколько раз дешевле за вызов, но чаще требовать проверки и исправления. Другая модель тратит больше токенов, зато сотрудники принимают её результат с меньшим числом правок. Если считать только API, побеждает первая; если считать принятые результаты и время команды, может победить вторая. Решение определяется измеренными частотами ошибок и ценой их исправления, а не названием модели.
Стройте границу выбора
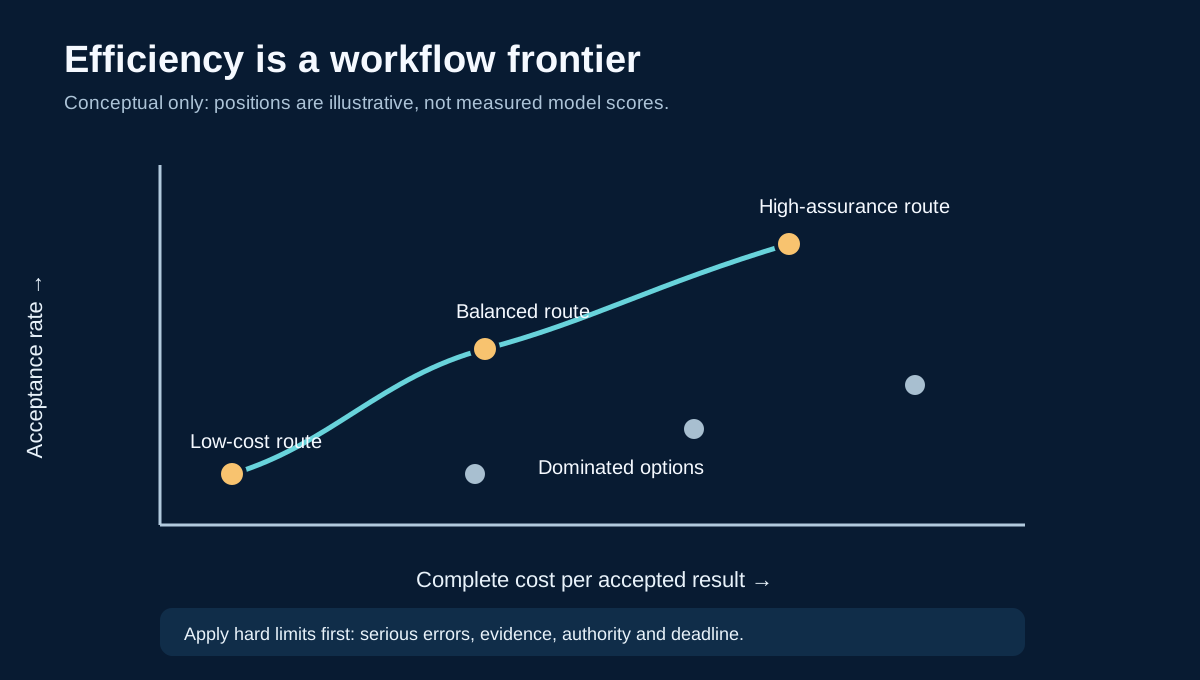
Для каждой конфигурации отметьте стоимость принятого результата и долю приемки. Вариант доминируется, если другой даёт не худшее качество при не большей полной стоимости. Остальные образуют практическую границу выбора: один вариант дешевле, другой точнее, третий быстрее. Добавьте жёсткие ограничения: например, 99% извлечения обязательного идентификатора и ноль автоматических платежей без подтверждения. Только после этого выбирайте точку на границе.
Полезен и маршрут моделей. Исследования FrugalGPT (откроется в новой вкладке) и RouteLLM (откроется в новой вкладке) показывают, что распределение запросов между моделями может улучшить соотношение цены и качества в изученных задачах. Их опубликованные проценты экономии зависят от набора случаев и не заменяют локальный тест. Простая политика для начала: дешёвая модель для типовых случаев, эскалация по явной неопределённости или признаку риска, выборочная проверка человека.
Минимальный протокол оценки
Зафиксируйте выборку до настройки промпта, отделите тренировочные и контрольные случаи, включите плохие сканы, двуязычные запросы и противоречивые документы. Попросите предметных специалистов оценить слепые результаты по рубрике. Замерьте долю эскалаций, повторов, p95 времени и полную стоимость. Через месяц повторите оценку: структура входящих запросов и версии моделей меняются.
Уровни метрик: от модели до результата бизнеса
На уровне модели измеряют точность, соблюдение формата, использование источника, токены и задержку. Это помогает отладке, но не доказывает, что бизнес-процесс стал лучше. На уровне процесса важны доля заявок, закрытых без повторного контакта, время до принятого результата, частота эскалаций и исправлений. На уровне организации — пропускная способность команды, удовлетворённость клиентов, выручка или снижение убытков при тех же требованиях к качеству. Между уровнями нет автоматического равенства: быстрый черновик может оставить время решения неизменным, если согласование остаётся узким местом.
Разделите метрики на цель, ограничение и диагностику. Цель может быть стоимость принятого ответа при нужном качестве. Ограничение — нулевые самостоятельные платежи без подтверждения или обязательная ссылка на политику. Диагностика — токены, размер контекста, частота повторов. Ошибка управления возникает, когда диагностика становится целью: команда начинает сокращать токены и ухудшает качество поиска либо снижает долю эскалаций, заставляя модель отвечать без доказательств.
Причинность: помог ли именно ИИ?
До внедрения зафиксируйте базовую линию. Затем сравните похожие случаи с ИИ и без него, по возможности распределяя работу случайно или вводя инструмент поэтапно. Смотрите не только среднее время оператора, но и повторные обращения, жалобы, нагрузку руководителей и качество решения через несколько дней. В исследовании Generative AI at Work (откроется в новой вкладке) эффект инструмента различался по опыту сотрудников; это предупреждает против одной средней цифры для всей команды.
Если после запуска показатели улучшились, возможны и другие причины: сезонность, изменение состава заявок, новая политика, дополнительное обучение сотрудников. При сравнении моделей внутри одного продукта сохраняйте одинаковую выборку и критерий приемки. Обновления провайдера должны проходить через повторную оценку, иначе модель может тихо изменить стиль отказа, формат и расход.
Ненадёжные метрики и «средняя температура»
Один балл бенчмарка скрывает распределение ошибок. Для документов обычно важны обязательные поля и редкие опасные пропуски; для агентных действий — разрешённость, обратимость и корректность состояния после действия. Смотрите p95 времени и стоимости, а также стоимость худших исправляемых случаев. Показатель «95% ответов выглядят хорошо» не говорит, что оставшиеся 5% безопасны.
Автоматический судья полезен для быстрой проверки тысяч ответов, но может предпочитать длинные уверенные формулировки и пропускать ошибки в специальных доменах. Калибруйте его на выборке с оценками специалистов и обновляйте при смене темы. Для RAG отдельно проверяйте качество найденных источников и верность ответа им; RAGAS (откроется в новой вкладке) и ARES (откроется в новой вкладке) дают методическую основу такого разделения.
Граница эффективности — не одна кривая навсегда
На графике стоимость–качество каждая точка должна означать целую конфигурацию: модель, промпт, источники, инструменты, маршрутизатор и правила проверки. При изменении одного элемента точку нужно измерить заново. Вторая координата тоже может меняться: иногда задача требует более быстрого результата даже при чуть большей стоимости. Тогда решения сравнивают по трём осям и применяют жёсткие ограничения безопасности.
Наконец, оценка должна быть связана с реальным решением. Если улучшение модели не изменяет долю приемки, время специалиста или риск, его академический балл не обязательно имеет денежную ценность для этого процесса. И наоборот, небольшой прирост надёжности на дорогом исключении может оправдать существенную разницу в тарифе.
Сквозной пример: измеряем поддержку магазина
Для вопросов о доставке определим принятие как корректный статус из системы заказов, применённое действующее правило и ответ без обещания, которого магазин не может выполнить. Для изменения адреса добавим правильное определение полномочия: до передачи перевозчику система может подготовить действие, после — обязана передать человеку. Для спорного возврата результатом может быть качественный пакет доказательств для сотрудника, а не автоматический ответ клиенту. Так один процесс получает несколько разных критериев успеха.
Соберите историческую выборку и затем новый поток. Исторические случаи удобны для повторяемого сравнения конфигураций, но могут не отражать новые форматы и изменившиеся правила. Новый поток показывает реальную смесь задач, однако требует защиты клиента и контролируемого запуска. На раннем этапе сравнивайте ответ ИИ с действием сотрудника в теневом режиме. Позже можно давать сотруднику черновик и наблюдать не только его скорость, но и число правок, причины отклонения и последующие обращения клиента.
Причины отклонений — отдельный источник архитектурных решений. «Не найден статус» указывает на интеграцию; «найдена старая политика» — на поиск и версии; «слишком уверенно обещал возврат» — на ограничение полномочий и формат ответа; «долго ждал проверку» — на очередь. Попытка исправить всё заменой модели обычно дороже и менее надёжна, чем изменение конкретного звена.
Оценка в условиях редких событий
Тяжёлые ошибки редки, поэтому малый пилот может случайно не увидеть ни одной. Отсутствие инцидента в небольшой выборке не доказывает нулевой риск. Дополняйте обычный поток специально подготовленными сценариями: неверная авторизация, просьба раскрыть данные другого клиента, конфликт статусов, устаревшая инструкция, неоднозначное согласие на действие. Оцените, может ли система не только отвечать, но и отступать до безопасного режима при неопределённости.
Расходы тоже следует смотреть по распределению. Одно дело — типовая цена письма. Другое — длинная цепочка с повторными вызовами инструментов, которая задерживает оператора и потребляет бюджет. Для агента важны лимит на шаг, стоимость длинного хвоста и количество случаев, завершившихся передачей человеку. Переход к следующему уровню автономии должен требовать устойчивости именно на исключениях, а не только хорошего среднего.
Когда оценка превращается в управление
После запуска назначьте владельца рубрики, данных и решения о смене модели. По нему должны быть понятны три действия: принять обновление, ограничить область автоматизации или откатить конфигурацию. Разбор инцидента должен сохранять версию промпта, модели, источников и инструментальных ответов. Без этого команда будет спорить о субъективном впечатлении вместо того, чтобы находить причину.
Небольшая регулярная выборочная проверка принятых ответов обнаруживает ошибки, которые не видны из жалоб. Клиент не всегда знает, что полученное правило было неверным; сотрудник может молча исправить черновик. Поэтому программа оценки не заканчивается после закупки. Она становится частью эксплуатации — примерно как контроль качества обычного бизнес-процесса.
Неопределённость измерения тоже нужно показать
Результат теста — оценка, а не точная константа модели. Если один вариант оказался немного лучше другого на небольшой выборке, различие может исчезнуть на новом потоке. Разбивайте оценку по типам задач и показывайте объём каждого сегмента. Для редкого опасного события важнее не красивый общий процент, а специально подготовленные испытания, разбор механизмов отказа и предел полномочий. Не следует делать вывод «безопасно» из нуля инцидентов в коротком пилоте.
При человеческой оценке проверяйте согласованность экспертов. Если два специалиста по-разному трактуют «хороший ответ», сначала уточните рубрику и политику, затем сравнивайте модели. Слепая оценка уменьшает влияние названия поставщика. Спорные случаи полезнее фиксировать отдельно: они показывают, где организации самой не хватает ясного правила.
В эксплуатации следите за дрейфом задачи: изменением языка обращений, поставщика документов, сезонности, политики, поведения клиентов. Модель может не меняться, но качество падать из-за другого входа. Сравнивайте текущую смесь случаев с тестовой, обновляйте выборку и сохраняйте несколько неизменных контрольных примеров для сравнения версий. После инцидента добавляйте новый класс теста, а не только одну копию конкретного промпта.
Когда прекращать оптимизацию
Измерение тоже стоит денег. Нет смысла бесконечно выжимать небольшую скидку из промпта, если главная задержка находится в ручном согласовании или данных. Завершайте цикл оптимизации, когда следующий эксперимент вряд ли изменит решение о маршруте и когда критические ограничения уже соблюдены. Возобновляйте его при заметном изменении цены, модели, потока или риска. Так оценка поддерживает управление, а не превращается в производство графиков ради графиков.
Вывод: эффективна не модель с лучшим ценником или единственным лучшим баллом, а конфигурация, которая устойчиво даёт нужный результат в конкретном процессе.
Далее: Полная стоимость ИИ-процесса.