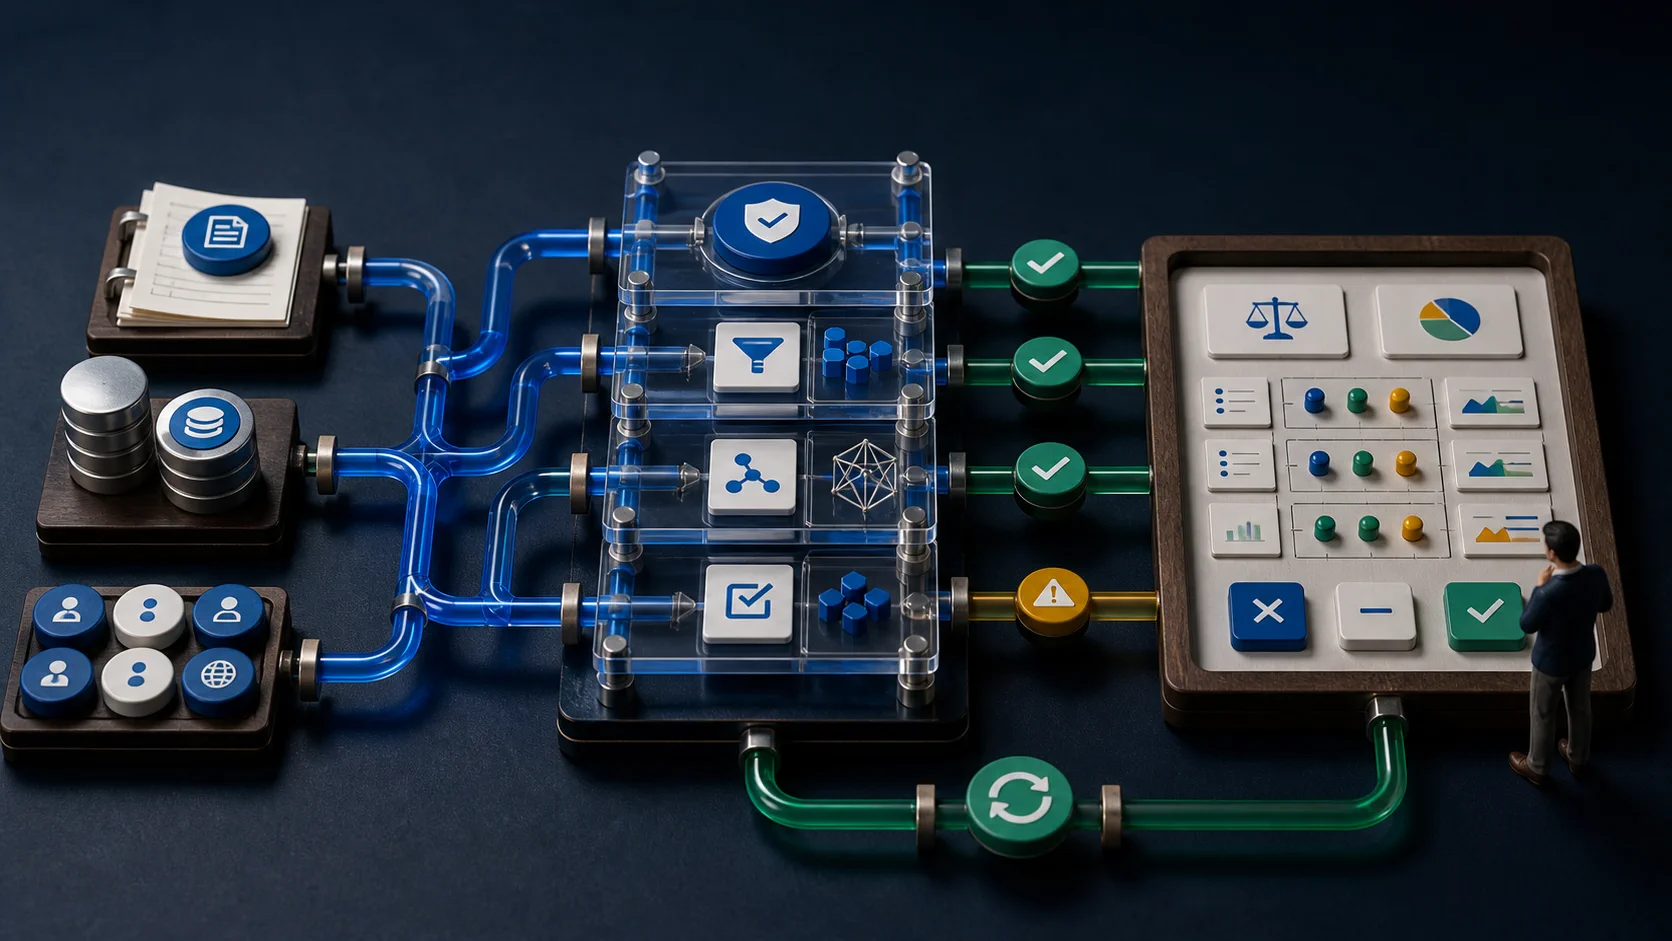
AI участвует во всём жизненном цикле дашборда: группирует интервью, предлагает описания метрик, пишет SQL или DAX, создаёт wireframe, отвечает на вопросы, ищет аномалии, объясняет изменения и запускает workflow.
Риск этих режимов различается. Помощник автора создаёт артефакт, который можно проверить до публикации. Runtime explanation формирует новый ответ для каждого пользователя. Runtime action уже меняет бизнес.
Безопасный принцип:
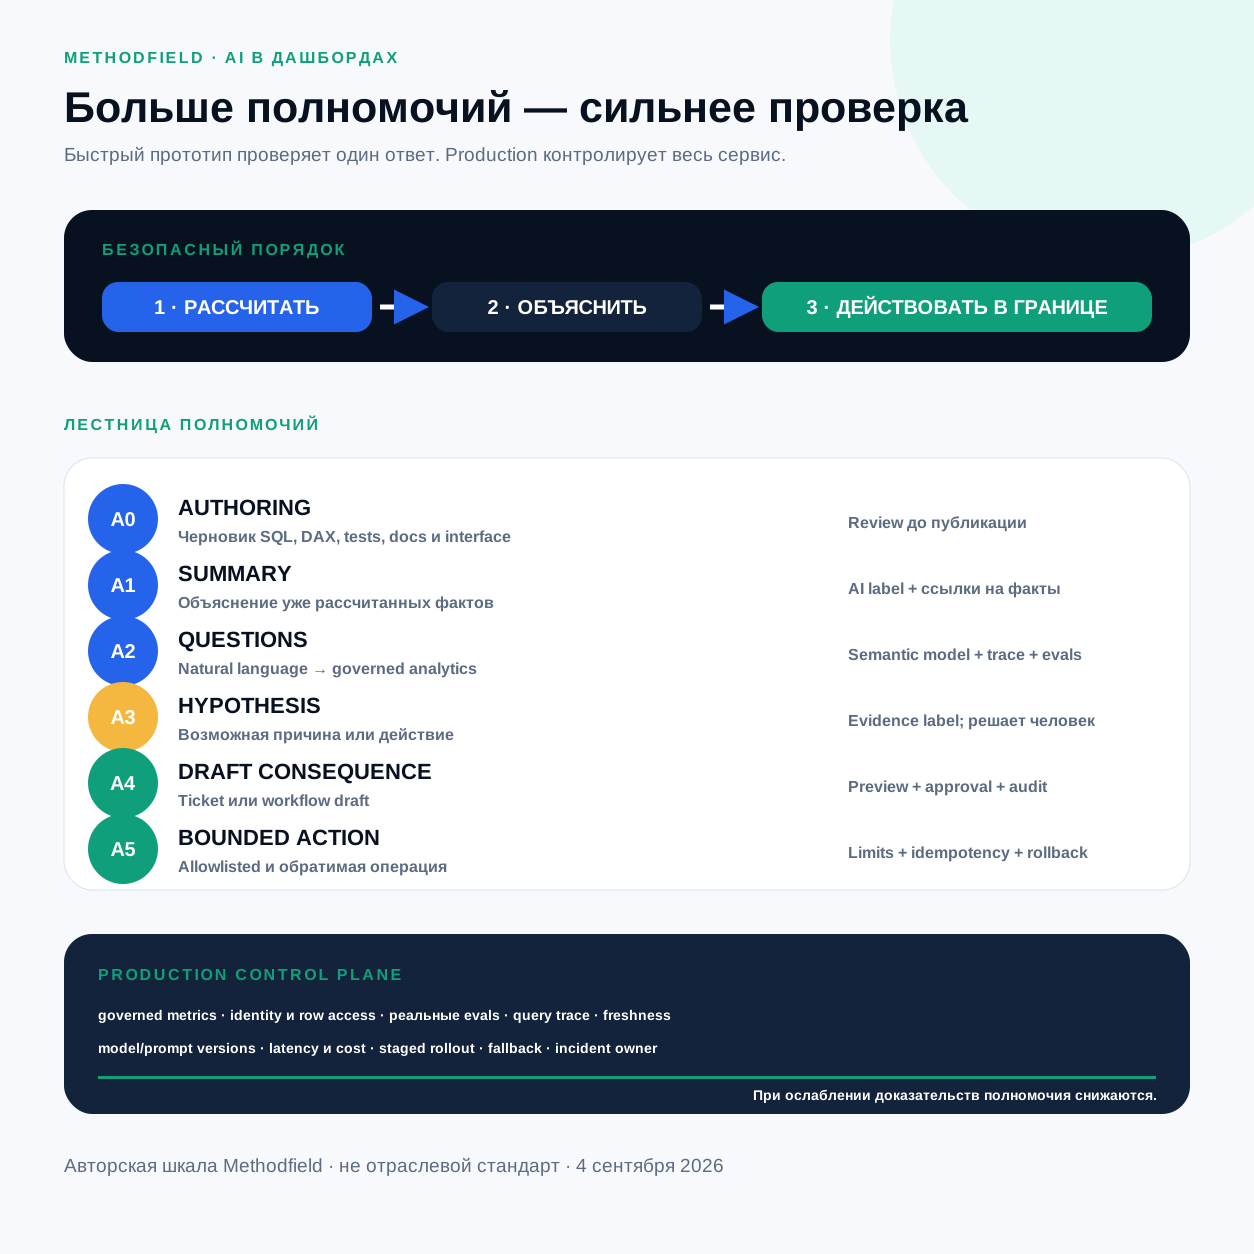
Сначала рассчитать. Затем объяснить. Действовать только в проверенной границе.
AI меняет интерфейс, но не отменяет семантику
Классический dashboard отвечает на ожидаемые вопросы: состояние, отклонение, тренд, сегмент. Conversational layer позволяет спросить:
Почему churn вырос у клиентов второго месяца в Южной Европе?
Система выбирает поля, строит query, visualisation и explanation. Но до этого организация всё равно должна определить churn, месяц клиента, регион, отмены и row access.
Google описывает Conversational Analytics в Looker как natural-language доступ поверх semantic model; LookML остаётся источником relationships, definitions и permissions. Microsoft советует готовить semantic model для Copilot и предупреждает, что nondeterministic output может быть неверным или различаться при повторе. Это product guidance, а не независимая гарантия accuracy. Looker (откроется в новой вкладке), Power BI (откроется в новой вкладке)
AI снижает стоимость формулировки запроса, но повышает требования к semantic control, observability и проверке ответа.
Семь полезных ролей AI
1. Исследователь требований
AI кластеризует интервью, извлекает вопросы, предлагает glossary и находит противоречия. Это вход для workshop, а не готовый набор KPI: модель не знает реальных decision rights, стимулов и цены ошибки.
2. Помощник моделирования
Модель черновит SQL, DAX, calculated fields, tests и documentation. Но синтаксически правильный query может размножить revenue через many-to-many join, выбрать неверную дату, сравнить открытый месяц с закрытым или забыть returns. Microsoft прямо рекомендует понимать и проверять generated DAX во всех filter contexts.
3. Создатель прототипа
AI быстро создаёт wireframe, chart specification, dashboard JSON или React component. Пометьте результат как прототип, отделите generated sample data от реальных значений и сверяйте query с известными cases.
4. Natural-language query
Пользователь задаёт вопрос, AI сопоставляет язык с утверждённым semantic model и возвращает число или график. Управляемый ответ показывает:
- интерпретированный вопрос;
- measures и dimensions;
- filters и time range;
- применённую identity/access scope;
- query или доступный query trace;
- freshness и quality state;
- исправление интерпретации;
- ссылку на certified dashboard state.
При неоднозначном revenue или прошлый месяц система должна уточнить, а не
незаметно угадать.
5. Narrative и data storytelling
Детерминированный слой считает значения, статистика выделяет contributions, trends и outliers. LLM получает только эти факты, ссылается на них и указывает ограничения.
Tableau описывает ответы Tableau Agent в Pulse как основанные на заранее рассчитанных statistical insights. Это полезный пример разделения, но не гарантия верности каждого текста. Tableau Pulse (откроется в новой вкладке)
6. Аномалии и прогноз
Здесь AI может означать статистику и ML: seasonal baselines, change points, forecast intervals, capacity или demand prediction. Для каждой аномалии нужны observed value, expected range, period, model version и reason code. Это сигнал для проверки, а не доказанная причина.
7. Рекомендация и действие
AI ранжирует исключения, предлагает владельца, создаёт ticket draft или workflow. Риск резко растёт при переходе от чтения к изменению.
Лестница полномочий AI в дашборде
| Уровень | Роль AI | Минимальный контроль |
|---|---|---|
| A0 | Помогает автору создать dashboard | Code/query/editorial review до публикации |
| A1 | Резюмирует рассчитанные факты | Видимый AI label и ссылки на факты |
| A2 | Отвечает на ad hoc вопросы | Semantic model, query trace, eval set |
| A3 | Предлагает причину или действие | Evidence label; решение принимает человек |
| A4 | Создаёт ticket/workflow draft | Preview, approval, audit trail |
| A5 | Выполняет ограниченное действие | Allowlist, limits, idempotency, rollback, monitoring |
Это авторская шкала Methodfield, а не отраслевой стандарт. Рост полномочий зависит от доказательств и последствий, а не от списка функций модели. При ослаблении data quality, performance или review capacity уровень снижается.
Почему прототип выглядит умнее production
Demo обычно использует одного автора, ожидаемые вопросы, маленькую чистую схему, статичные данные, широкий доступ, известный правильный ответ и неизмеряемую стоимость. Плохой ответ можно незаметно повторить.
Production добавляет synonyms, жаргон, неоднозначные даты и currencies, тысячи полей, metric versions, row permissions, неполные refresh, разные языки, ошибочные вопросы, load, budget, воспроизводимость и реальные последствия.
Поэтому PoC проверяет не «смог ли AI один раз построить график», а «какая доля реальных вопросов получает проверяемый ответ в нужных правах, времени и цене».
Ограничьте модель управляемыми объектами
Semantic model: разрешите только утверждённые measures, dimensions, joins и descriptions. Свободный text-to-SQL ко всей production-базе даёт языковой неоднозначности максимальный blast radius.
Verified questions: храните intent–query pairs для частых формулировок вроде
net revenue за последний закрытый месяц. Это examples, regression tests и
fallback. Looker документирует verified queries для data agents; доступность
зависит от edition и release state.
Controlled retrieval: объяснение получает актуальный metric contract, glossary, release annotations и runbook, а не случайное интернет-определение.
Deterministic calculation: модель выбирает intent и query structure, но деньги, проценты, статистика и thresholds считаются кодом или database.
Output contract: сначала возвращайте проверяемые поля, затем текст:
{
  "answer_status": "verified | provisional | unable",
  "measure_ids": ["net_revenue_v3"],
  "filters": {"region": "Southern Europe"},
  "period": {"from": "2026-08-01", "to": "2026-08-31", "closed": true},
  "source_freshness": "2026-09-03T08:40:00+01:00",
  "quality_status": "passed_with_warning",
  "result_refs": ["query_run_..."],
  "narrative": "...",
  "limitations": ["Carrier adjustments arrive with a two-day lag"]
}
Production output не раскрывает скрытые identifiers и sensitive payload.
Создайте eval set до запуска
Соберите реальные вопросы из встреч, tickets и интервью. 50–200 — стартовый диапазон, не стандарт; важнее покрытие и риск. Для вопроса сохраните paraphrases, expected intent, допустимые measures/filters, правильный результат на versioned fixture, обязательное уточнение, запрещённые поля, latency и severity.
| Метрика | Что проверяет |
|---|---|
| Intent accuracy | Понят ли бизнес-вопрос |
| Measure selection | Выбрано ли утверждённое определение |
| Filter/time accuracy | Верны ли сегмент и период |
| Numeric correctness | Совпадает ли расчёт |
| Citation/trace coverage | Можно ли проверить ответ |
| Clarification rate | Выявлена ли неоднозначность |
| Unsupported-answer rate | Есть ли отказ при отсутствии доказательств |
| Permission violations | Соблюдён ли scope |
| Narrative faithfulness | Следует ли текст из query results |
| Repeat consistency | Сохраняется ли смысл при повторе |
| Latency and cost | Устойчива ли эксплуатация |
Используйте severity-weighted gates: косметическая ошибка и раскрытие финансовых данных другому tenant не равны. NIST AI 600-1 организует risk work через Govern, Map, Measure, Manage по жизненному циклу; это добровольный cross-sector framework, а не готовый порог аналитики. NIST AI 600-1 (откроется в новой вкладке)
Практика связана с руководством AI Evaluation Operations.
Измеряйте реальный сервис
После запуска считайте answers/clarifications/refusals, corrections, regenerations, переходы к source/query detail, расхождения с certified dashboard, failed/slow queries, semantic changes, cost per useful answer, privacy events, overrides, incidents и time to contain.
Не оптимизируйте только thumbs-up. Убедительный неверный ответ может нравиться. Feedback отбирает cases для review, но не является ground truth.
Сделайте доверие видимым
Пользователь должен различать значение semantic query, статистическую
аномалию, AI narrative, AI hypothesis и recommended action. Рядом нужны metric
definition, freshness, warnings, filters, period, source aggregates, lineage,
annotations и limitations. Разрешите исправить invoice date на order date,
не меняя глобальную метрику автоматически.
Если данных недостаточно, верните unable, объясните причину и безопасный
следующий шаг. Гладкий текст не заменяет факт.
Защитите identity, access и данные
Conversational layer расширяет поверхность запроса. Сохраняйте user identity end to end; применяйте row/column/tenant rules до query; не позволяйте prompt раскрыть hidden fields; не логируйте лишний sensitive payload; защищайте retrieved documentation от injection; контролируйте exports и generated links; задайте retention и residency; red-team тестируйте indirect disclosure и small groups.
Google указывает, что Looker Conversational Analytics соблюдает LookML
permissions, но также документирует compliance и geographic limits отдельных
режимов. AI внутри BI не заменяет privacy/compliance review.
Эксплуатируйте AI как versioned product
Версионируйте model/provider, instructions, semantic model, metric definition, query planner, tools, eval set, release и rollback target. Любое изменение запускает regression по intent, query plan, numeric result, permissions и unsupported behaviour, а не по точному тексту.
Rollout идёт от внутренних авторов к одной business group и далее. Сравнивайте с deterministic baseline по correctness, времени, workload, cost и рискам.
Если AI недоступен или ниже threshold, остаются certified dashboard states, verified questions, manual filters и analyst escalation. Отказ narrative не должен скрыть deterministic facts.
План первого месяца
Неделя 1: одна аудитория и decision workflow; три–пять metric contracts; реальные вопросы и forbidden answers.
Неделя 2: deterministic dashboard, reconciliation, freshness, quality, lineage, action и fallback.
Неделя 3: authoring assistant или natural-language query для тестовой группы; только governed objects; trace, AI status, eval и red-team.
Неделя 4: сравнение с baseline; accuracy, workload, latency, cost, privacy; уровень A1/A2/A3, owner, cadence и stop rules.
Успешный месяц может закончиться надёжным детерминированным дашбордом, где AI использует только автор. Быстрый прототип ещё не является production-сервисом.
Источники
Первичные и официальные материалы приведены рядом с утверждениями. Основные источники:
- Microsoft — Use Copilot with semantic models (откроется в новой вкладке).
- Google Cloud — Conversational Analytics in Looker (откроется в новой вкладке).
- Tableau — About Tableau Pulse (откроется в новой вкладке).
- NIST AI 600-1 — Generative Artificial Intelligence Profile (откроется в новой вкладке).
Источники подтверждают архитектуру, заявленные функции, ограничения и практики управления риском. Они не доказывают самостоятельно правильность AI-ответа в конкретной организации. Лестница A0–A5 — авторский инструмент Methodfield, а не отраслевой стандарт.
Обсудить ваш процесс
Принесите одно детерминированное состояние дашборда и десять реальных вопросов, которые люди задают к нему. Этого достаточно, чтобы определить semantic objects, permission boundary, первые eval cases и максимальный уровень полномочий AI, поддерживаемый текущими доказательствами.
Начните с информационной модели доверенного дашборда и архитектуры source-to-screen.