AI-кейсы часто сжимают сложное вмешательство до одного предложения:
Компания внедрила AI и сократила время обработки на 60%.
Утверждение может быть точным. Но в нём может не быть сведений, необходимых для вашего решения:
- Что измерялось?
- Каким был исходный уровень?
- Менялся ли одновременно сам процесс?
- Были ли исключены сложные случаи?
- Выполняли ли сотрудники скрытую проверку или очистку?
- Результат получен в пилоте или в обычной работе?
- Изменились ли качество, стоимость или результат для клиента?
- Сохранится ли эффект в другой команде, на других данных или объёме?
Кейс полезен, пока вывод остаётся внутри границы доказательств. Он становится опасным, когда локальное наблюдение превращается в причинное и переносимое обещание.
Короткий ответ
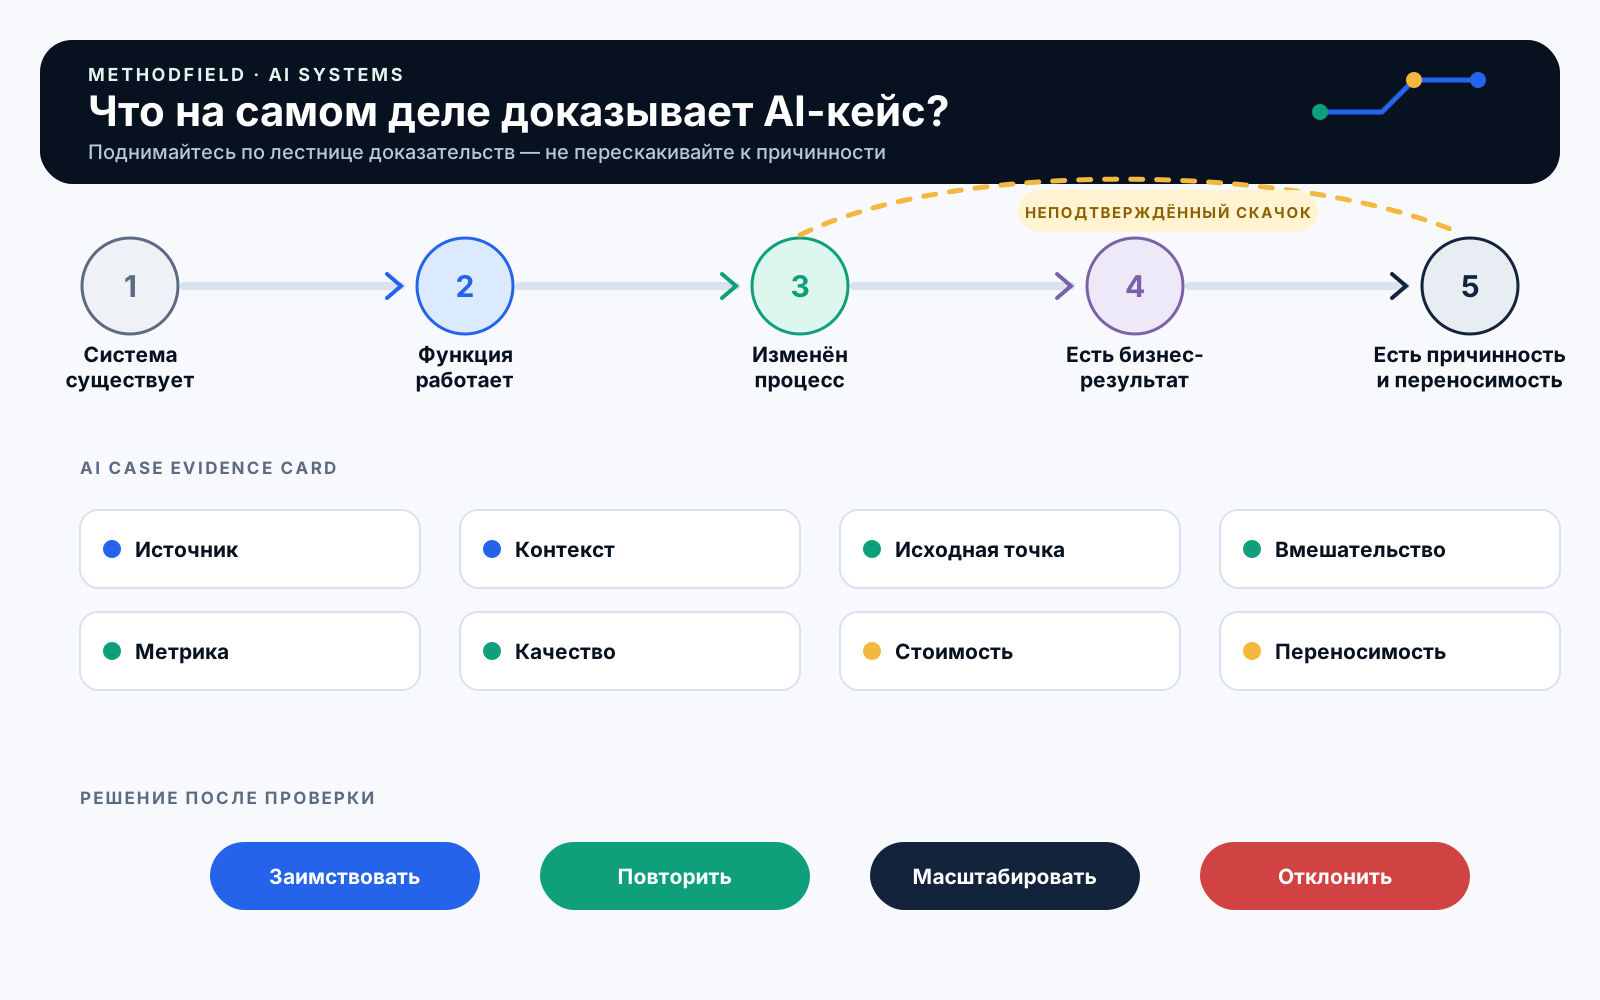
Читайте каждый AI-кейс на пяти уровнях:
- Существование: система создана или внедрена.
- Способность: она получила определённый результат на выбранных примерах.
- Результат процесса: изменился операционный показатель.
- Бизнес-результат: изменились стоимость, риск, выручка или клиентский опыт.
- Причинность и переносимость: вмешательство вызвало изменение, а механизм с высокой вероятностью сработает в другом контексте.
Доказательство одного уровня автоматически не подтверждает следующий.
Рабочее демо подтверждает существование. Оценка на тестовом наборе даёт сведения об определённой способности. Более быстрый пилот показывает наблюдаемое изменение процесса. Ничто из этого само по себе не доказывает устойчивый бизнес-результат или такой же эффект в другой организации.
Результат и причинность — разные вопросы
Мониторинг показывает, что что-то изменилось. Причинность отвечает на вопрос, вызвало ли изменение именно AI-вмешательство.
Руководство правительства Великобритании Quality in Policy Impact Evaluation проводит это различие прямо: наблюдения результата недостаточно, чтобы заключить, что за него отвечает вмешательство. Требуется сравнение или убедительное описание контрфактического сценария.
Малому бизнесу не нужно академическое исследование для каждого workflow. Но формулировка должна соответствовать силе доказательства.
Сравните:
- «Во время четырёхнедельного пилота время ответа снизилось».
- «AI-система сократила время ответа».
- «AI-система сократит время ответа в вашей компании».
Первое — наблюдение. Второе — причинное утверждение. Третье добавляет переносимость. Каждая следующая формулировка требует более сильного доказательства.
AI Case Evidence Card
Используйте карточку до цитирования кейса в предложении или одобрения проекта на его основе. Это рабочий инструмент Methodfield, а не валидированная шкала качества исследования.
1. Источник и интерес
Зафиксируйте, кто опубликовал кейс и кому выгодно утверждение.
Возможные типы источников:
- организация, использующая систему;
- поставщик системы;
- совместный customer story;
- регулятор или государственный орган;
- независимая оценка;
- публикация СМИ, пересказывающая другой источник.
Кейс поставщика может содержать полезные операционные сведения. Его следует маркировать как vendor-reported и учитывать отсутствующие стимулы и методы.
2. Контекст и граница
Зафиксируйте:
- организацию и бизнес-модель;
- страну и регуляторный контекст;
- workflow и пользователей;
- тип данных;
- выборку или объём;
- статус пилота или production;
- период;
- включённые и исключённые случаи.
Без этой границы нельзя оценить релевантность.
3. Baseline и сравнение
Спросите, что произошло бы без вмешательства.
Полезные сравнения:
- тот же процесс до внедрения;
- параллельная команда или площадка;
- случайное распределение случаев;
- поэтапный запуск;
- определённый business-as-usual процесс;
- повторные измерения до и после изменения.
Сравнение «до и после» часто практично, но остаётся уязвимым для других изменений, происходивших одновременно.
4. Вмешательство
Опишите, что именно изменилось.
«Внедрили AI» недостаточно. В кейсе следует различать:
- модель или сервис;
- промпт, правила и источники знаний;
- интеграции;
- человеческую проверку;
- изменение процесса;
- обучение и поддержку;
- изменение состава команды или часов обслуживания;
- fallback и обработку исключений.
Так становится виден механизм. Модель не получает заслугу за всё операционное изменение целиком.
5. Показатель
Зафиксируйте определение метрики, а не только число.
Например, «время обработки» может означать:
- время работы модели;
- рабочее время сотрудника;
- полный срок от поступления до завершения;
- время без учёта эскалаций;
- время до черновика, а не до утверждённого результата.
Период, знаменатель и учёт ошибок меняют смысл результата.
6. Качество и непреднамеренные эффекты
Эффективность следует читать рядом с показателями:
- исправлений и повторной работы;
- последствий false positive и false negative;
- эскалаций;
- жалоб;
- различий результата между группами;
- обходных действий пользователей;
- новых рисков и задержек дальше по процессу.
Более быстрый процесс, передающий больше ошибок на следующий этап, не обязательно стал лучше.
7. Ресурсы и стоимость эксплуатации
Зафиксируйте ресурсы, добавленные только в пилоте:
- экспертов-проверяющих;
- ручную подготовку данных;
- поддержку поставщика;
- временные интеграции;
- бесплатные кредиты;
- необычно узкую область;
- отобранных пользователей или случаи.
Разделяйте стоимость создания, регулярную стоимость и человеческий контроль. Технически успешный кейс может иметь невыгодную операционную модель.
8. Повторяемость и граница переноса
Спросите:
- Повторялся ли результат?
- Сохранился ли он при росте объёма?
- Получили ли его новые пользователи?
- Какие данные, навыки и условия процесса были необходимы?
- Что именно переносится: технология, паттерн процесса или только проверяемый вопрос?
Часто наиболее переносим не процент из заголовка, а архитектура: извлечь, проверить, направить, подтвердить и записать.
Синтетический пример
Представим, что поставщик сообщает: ритейлер применил AI для проверки информации о товарах и сократил время подготовки на 60%.
Кейс может поддерживать следующую формулировку:
В описанном workflow и периоде комбинированный процесс AI плюс проверка выполнил выбранную задачу подготовки информации быстрее прежнего подхода.
Но он автоматически не доказывает:
- AI вызвал всё улучшение;
- информация стала точнее;
- затраты на труд снизились на 60%;
- результат относится ко всем категориям товаров;
- другая компания получит такой же эффект;
- информацию можно выпускать без проверки человеком.
Правильное следующее действие — не отвергать кейс, а заимствовать паттерн и спроектировать локальную проверку отсутствующих вопросов.
Четыре решения после чтения кейса
Заимствовать паттерн
Выбирайте, если механизм релевантен, но заявленный результат не переносим. Преобразуйте кейс в локальную гипотезу.
Повторить локально
Выбирайте, если ожидаемая ценность существенна, а главную неопределённость можно проверить на репрезентативных случаях с baseline и контролируемой границей.
Осторожно масштабировать
Выбирайте, если результат выдержал повторное использование, нормальные условия и определённые ворота качества. При расширении сохраняйте мониторинг и условие остановки.
Отклонить вывод
Выбирайте, если публичное утверждение выходит за границу доказательств, контекст существенно отличается или вмешательство нельзя восстановить для проверки.
Отклонение вывода не означает бесполезность технологии. Это означает, что кейс не поддерживает предлагаемое решение.
Проектируйте прототип для получения доказательств
Полезный прототип отвечает на четыре класса вопросов.
Способность
Может ли система выполнить ограниченную задачу на репрезентативных случаях?
Процесс
Снижает ли она полный срок, рабочее время, неполноту или повторную работу после учёта проверки и исключений?
Последствия
Что происходит при ошибке, неопределённости или недоступности системы?
Бизнес-эффект
Улучшает ли изменённый workflow результат, который оправдывал проект, при приемлемой стоимости эксплуатации?
Руководство Великобритании по оценке AI-вмешательств рекомендует заранее определять baseline, описывать business as usual, рассматривать сравнение и адаптировать оценку по мере изменения системы. Эти принципы полезны и для малого бизнеса при пропорциональном применении без формального impact study.
Связь с существующим контентом Methodfield
Гайд От наблюдения к действию определяет ворота доказательств до расширения полномочий. Этот материал уточняет, что доказательства на таких воротах могут и не могут утверждать.
AI Automation Should Improve Quality показывает, как AI может проверять процесс, а не только создавать результат. Такое же разделение требуется при оценке: система не должна создать результат, объявить его правильным и считать это независимым доказательством качества.
Типичные ошибки доказательности
- процент без знаменателя или периода;
- vendor-reported результат как независимая оценка;
- выбранный пилот, названный production;
- скорость модели вместо полного времени процесса;
- исключение проверки и исправлений из стоимости;
- корреляция, представленная как причинность;
- перенос эффекта только из-за одинакового названия отрасли;
- скрытые ошибки и эскалации;
- изменение метрики после получения результата;
- testimonial вместо объективного доказательства.
Итоговая позиция
AI-кейс — не обещание. Это ограниченное доказательство о системе, процессе и контексте.
Используйте публичные кейсы для поиска паттернов и вопросов. Локальным прототипом проверяйте механизм. Производственным мониторингом проверяйте, выдерживает ли результат реальную работу.
Честный вывод часто уже заголовка — и намного полезнее для решения.
Источники
- HM Treasury и Evaluation Task Force, Guidance on the Impact Evaluation of AI Interventions (откроется в новой вкладке), обновлено 15 мая 2026 года.
- HM Treasury и Evaluation Task Force, The Magenta Book (откроется в новой вкладке), обновлено 15 мая 2026 года.
- UK Government, Quality in Policy Impact Evaluation (откроется в новой вкладке), обновлено 15 мая 2026 года.
- NIST, AI Risk Management Framework Core (откроется в новой вкладке), версия доступна 26 августа 2026 года.
- US Federal Trade Commission, Advertising FAQs: A Guide for Small Business (откроется в новой вкладке), версия доступна 26 августа 2026 года.